






Fork Pearl FP8 vysvětlen: které GPU budou dál těžit
Pearl (PRL) se chystá na největší změnu od svého spuštění. Návrh s názvem PIP-3 převádí těžbu Pearl z celočíselné matematiky na FP8. FP8 je 8bitový formát s plovoucí desetinnou čárkou, ve kterém běží moderní modely AI.
Změna je hard fork, takže se musí aktualizovat každý node. Tak, jak je dnes napsaná, navíc zkracuje seznam grafických karet, které mohou těžit.
Tento článek vysvětluje, co se mění a proč se seznam hardwaru zužuje. Ukazuje, kterých karet se to týká a co dělat, dokud žádné datum forku neexistuje.
Stručně
- Těžba Pearl přechází z celočíselné matematiky (INT7) na 8bitovou plovoucí čárku (FP8), formát čísel, ve kterém běží modely AI.
- Podle návrhu budou po forku těžit jen GPU NVIDIA Hopper a Blackwell. Karty GeForce RTX 40, RTX 30 a RTX 20 nebudou, stejně jako žádné GPU od AMD ani Intelu.
- Blok forku není stanoven. Nejnovější vydání Pearl, v1.5.5 z 28. října 2026, neobsahuje žádný kód FP8.
- Dokud některé vydání neuvede blok forku, nic se nemění. Těžte dál tak jako dnes.
Co těžaři Pearl počítají dnes
Pearl používá Proof of Useful Work (PoUW). Místo hashování náhodných čísel dělá těžař práci, která je užitečná i mimo řetězec. Tady je to násobení matic, krok, na který trénování a inference AI spotřebují nejvíc času.
K maticím se přidává náhodný šum, aby se výsledek nedal uhodnout. Součin se rozřeže na malé bloky, kterým se říká dlaždice. Z každé dlaždice se stane číslo, které funguje jako los v loterii.
Los pod cílem poolu se počítá jako share. Los pod mnohem těžším cílem sítě je blok. Důkaz s nulovou znalostí, krátký důkaz, že výpočet proběhl správně, umožní každému nodu práci levně ověřit.
Dnes jsou hodnoty matic 8bitová celá čísla s jedním bitem rezervy. Specifikace tomu říká INT7. Součiny se sčítají do 32bitových celých čísel (INT32).
Celočíselná matematika dává na každém čipu stejný výsledek. To je jeden z důvodů, proč se Pearl dá dnes těžit na kartách NVIDIA RTX řady 20 a novějších. Podle mineru běží i na GPU od AMD a Intelu.
Co mění PIP-3
PIP-3 nese název FP PoUW Certificates. Tým Pearl ho zveřejnil 30. července 2026 se stavem Draft (návrh). Nahrazuje celočíselné schéma schématem s plovoucí čárkou.
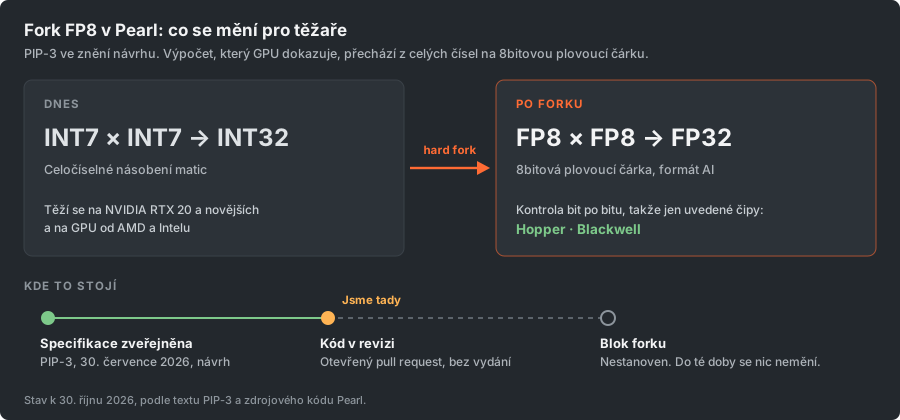
FP8 je číslo, které se vejde do 8 bitů. Na rozdíl od celého čísla umí uložit i zlomky. PIP-3 používá rozložení E4M3: jeden bit znaménka, čtyři bity exponentu a tři bity mantisy.
Bity exponentu určují velikost čísla a bity mantisy jeho přesnost. Největší hodnota E4M3 je 448. Součiny se sčítají ve 32bitové plovoucí čárce (FP32).
Každý řádek matice navíc dostane vlastní měřítko. Díky tomu jeho čísla zůstanou v malém rozsahu FP8.
| Co se změní | Dnes | Po forku FP8, podle návrhu |
|---|---|---|
| Formát čísel | INT7, 8bitové celé číslo | FP8, rozložení E4M3 |
| Součiny se sčítají do | INT32, 32bitové celé číslo | FP32, 32bitová plovoucí čárka |
| Stejný výsledek na každém čipu | Ano | Ne, jen v rámci jedné rodiny čipů |
| GPU, které mohou těžit | NVIDIA RTX 20 a novější; AMD a Intel podle mineru | Jen NVIDIA Hopper a Blackwell |
Návrh jako důvod uvádí užitečnost. Téměř všechny modely AI jsou ze své podstaty v plovoucí čárce. Skutečná inference už násobí v FP8 a výsledky drží v FP32.
Důkaz postavený na stejném kroku tak může běžet spolu se skutečnou prací modelu. Návrh tomu říká téměř dokonalé dva v jednom.
Referenční miner na vývojové větvi ukazuje tuto myšlenku v praxi. Je to plugin pro modelový server vLLM a těží, zatímco GPU obsluhuje model AI.
Návrh otevřeně mluví o ceně. Výsledky v plovoucí čárce nejsou bit po bitu shodné s ideální odpovědí, takže výstup je mírně ztrátový. Tým u testovaných modelů neuvádí žádnou znatelnou změnu přesnosti.
Výsledky v plovoucí čárce se také liší mezi rodinami čipů. Tím se dostáváme k části, která je pro těžaře nejdůležitější.
Proč se seznam GPU zkracuje
Dvě rodiny GPU mohou vynásobit stejné matice FP8, a přesto se lišit v posledním bitu. Každá rodina sčítá a zaokrouhluje čísla po svém.
Pro Pearl je to skutečný problém, protože síť nemůže přijmout výsledek, který je jen blízko. Návrh vysvětluje proč. Jakákoli tolerance v kontrole by těžaři dovolila výstup trochu posunout a získat losy navíc bez práce navíc.
Kontrola proto musí výpočet těžaře zopakovat přesně.
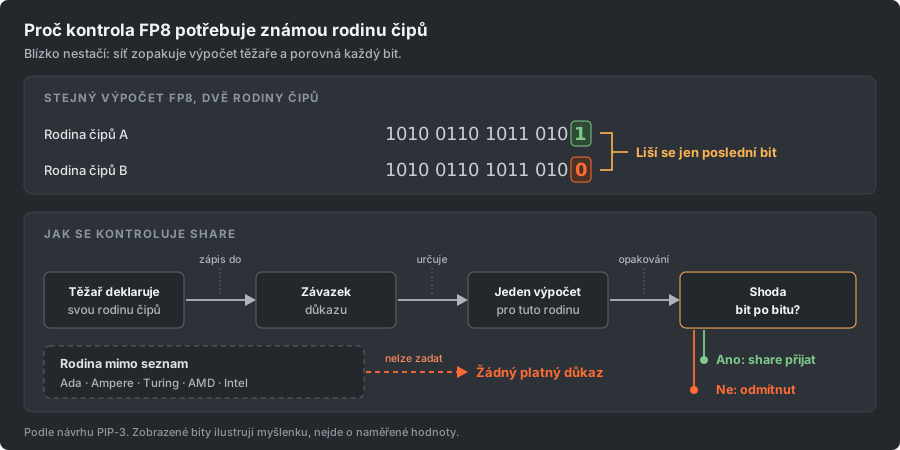
Aby to šlo, těžař předem ohlásí svou rodinu čipů. Rodina se zapíše do závazku, na kterém je postaven každý důkaz. Těžař i ověřovatel pak sledují jeden pevně daný výpočet pro tuto rodinu.
Ohlásit lze jen rodiny z whitelistu a PIP-3 jich uvádí dvě: Hopper a Blackwell. Karta z jakékoli jiné rodiny nemá platný způsob, jak svou práci prokázat. To platí bez ohledu na to, jak rychlá je v FP8.
Které GPU budou těžit dál a které ne
Referenční miner na vývojové větvi se spustí na čipech uvedených níže. Na všem ostatním se spustit odmítne.
Nevíte, do které rodiny vaše karta patří? Seznam GPU s CUDA od NVIDIA uvádí compute capability každé karty. 9.0 je Hopper, 10.0 a vyšší je Blackwell a 8.9 je Ada.
| Rodina GPU | Příklady karet | Po forku, podle návrhu |
|---|---|---|
| Hopper | H100, H200 | Těží dál |
| Blackwell | B200, RTX PRO 6000, GeForce RTX řady 50 | Těží dál |
| Ada | GeForce RTX řady 40, L40S | Končí v bloku forku |
| Ampere | GeForce RTX řady 30, A100 | Končí v bloku forku |
| Turing | GeForce RTX řady 20 | Končí v bloku forku |
| AMD a Intel | Každý model | Končí v bloku forku |
Jedno upozornění pro majitele GeForce RTX 50. Poznámky k referenčnímu mineru uvádějí, že jeho testy běží na B200.
Tytéž poznámky uvádějí, že jeden tvar dlaždice zatím nemá na kartách RTX 50 kernel. Vrstvy, které umí těžit jen tento tvar, jsou proto vynechány. Žádný zveřejněný test zatím neukazuje těžbu FP8 na kartě GeForce RTX 50.
Samostatný problém má dnešní oficiální miner na hlavní větvi. Je postavený jen pro čipy Hopper. Dvě otevřená hlášení ukazují, že na kartách RTX 50 selhává: žádný kernel pro RTX 50 a chyba GEMM na RTX 5070.
Dvě věci zatím nejsou známé. Nikdo nezveřejnil, kolik paměti GPU nové schéma na dané kartě potřebuje. Nikdo zatím neumí říct, zda ho dnešní těžební programy budou podporovat.
Návrh vyžaduje, aby každý miner přesně dodržel referenční výpočet. Každý program, který chce po forku těžit, s ním proto musí souhlasit bit po bitu.
Co je v návrhu stále otevřené
PIP-3 je návrh a text to na několika místech říká. Tyto části jsou stále označené k rozhodnutí, než návrh přejde do dalšího stavu:
- Kompaktní formát, ve kterém mohou být matice uložené před převodem na FP8.
- Statistické kontroly, kterými musí projít vítězná dlaždice.
- Testovací vektory a zveřejněné experimenty.
- Odkaz na referenční miner.
- Plán nasazení.
Vývojový kód se od textu místy také posunul dál. Například už zvládá vrstvy mixture of experts. To je návrh modelu AI, ve kterém pro každý vstup běží jen část modelu.
Také čísluje verzi certifikátu jinak. U návrhu je to normální. Znamená to ale, že se detaily ještě mohou změnit, včetně toho, jaký hardware bude přijat.
Kdy se to stane
Žádné datum není. Fork Pearl se aktivuje ve výšce bloku zapsané v softwaru nodu. Pro tento fork žádná výška na mainnetu neexistuje.
V kódu, který prochází revizí, je výška forku nastavena jen pro lokální testovací sítě vývojářů. Nejnovější vydání Pearl, v1.5.5 z 28. října 2026, neobsahuje vůbec žádný kód FP8. Až nějaké vydání výšku stanoví, právě to číslo si poznamenejte.
Pearl už konsenzus několikrát změnil. Každá z těch změn se aktivovala v pevném bloku uvedeném ve vydání. Těžař, který zná číslo bloku a aktualizuje před ním, nepřijde o nic.
Co dělat teď
- Těžte dál. Váš miner, nastavení i výplaty fungují až do bloku forku přesně jako dřív. Kvůli návrhu nic neměňte.
- Najděte rodinu své karty v tabulce výše nebo podle compute capability na seznamu NVIDIA.
- S kartou Hopper nebo Blackwell počítejte s tím, že před blokem forku nainstalujete miner podporující schéma FP8, jakmile nějaký bude.
- Na jakékoli jiné kartě těžte Pearl až do bloku forku. Už teď si vyberte, kterou minci bude karta těžit potom. Seznam nejlepších GPU pro těžbu a kalkulačka těžby ukazují, kolik vaše karta vydělá na jiných mincích.
- Sledujte stránku vydání Pearl a repozitář návrhů Pearl kvůli výšce forku.
- V den forku hodnoťte miner podle přijatých shares v poolu, ne podle hashrate, který vypisuje. Zastaralý miner může hlásit zdravý hashrate, i když se mu žádná práce nepočítá.
Uvažujete o koupi hardwaru pro Pearl? Kupujte podle toho, co síť přijímá dnes a co přijme konečná verze. Nekupujte podle návrhu, který se ještě může změnit.
Často kladené otázky
Bude RTX 4090 po forku FP8 dál těžit Pearl?
Ne podle současného znění PIP-3. RTX 4090 je karta Ada a Ada na seznamu rodin čipů v návrhu není. Platí to, i když umí počítat FP8 hardwarově. Až do bloku forku těží Pearl normálně.
Bude RTX 5090 dál těžit Pearl?
Podle návrhu ano. GeForce RTX řady 50 je Blackwell a referenční miner na vývojové větvi se na ní spustí. Žádný zveřejněný test zatím neukazuje těžbu FP8 na kartě GeForce RTX 50.
Mohou GPU od AMD nebo Intelu těžit Pearl po forku?
Podle návrhu ne. Návrh přijímá jen NVIDIA Hopper a Blackwell. Karty AMD a Intel dnes Pearl těžit mohou, podle mineru. Budou to dělat až do bloku forku.
Proč rychlá RTX 4090 nemůže těžit Pearl s FP8?
Rychlost problém není. Každá rodina čipů zaokrouhluje výpočty v plovoucí čárce trochu jinak. Síť musí výsledek těžaře zopakovat bit po bitu. To vyžaduje jeden pevný, dohodnutý výpočet pro každou rodinu a návrh ho definuje jen pro Hopper a Blackwell.
Kdy bude fork Pearl FP8?
Žádné datum ani výška bloku nejsou stanoveny. Nejnovější vydání, v1.5.5 z 28. října 2026, neobsahuje žádný kód FP8. Výška bude uvedena ve vydání, jakmile bude zvolena.
Musím dnes něco udělat?
Ne. Těžte dál jako teď. Jednejte, až nějaké vydání uvede blok forku. Pokud je vaše karta Hopper nebo Blackwell, aktualizujte miner, jinak kartu přesuňte na jinou minci.
Odkud tato fakta pocházejí
Každé tvrzení zde lze ověřit. Schéma, jeho motivace, whitelist hardwaru a otevřené body pocházejí z textu PIP-3. Ten je ve veřejném repozitáři návrhů týmu Pearl.
Podpora GPU pochází z referenčního mineru na vývojové větvi FP8 v repozitáři Pearl. Tento miner uvádí čipy, na kterých se spustí.
Stav aktivace pochází ze síťových parametrů ve stejném kódu. Výška forku FP8 je tam nastavena jen pro testovací sítě. Pochází také z nejnovějšího vydání.
Kde zdroje mlčí, například o potřebě paměti nebo o podpoře v jiných minerech, článek to říká. Nehádá.