






Pearlin FP8-fork selitettynä: mitkä GPU:t louhivat yhä
Pearl (PRL) valmistautuu suurimpaan muutokseensa julkaisunsa jälkeen. PIP-3-niminen ehdotus siirtää Pearl-louhinnan kokonaislukulaskennasta FP8:aan. FP8 on 8-bittinen liukulukumuoto, jossa nykyaikaiset tekoälymallit toimivat.
Muutos on hard fork, joten jokainen node on päivitettävä. Nykyisessä muodossaan se myös lyhentää listaa näytönohjaimista, joilla voi louhia.
Tämä kirjoitus kertoo, mikä muuttuu ja miksi laitteistolista kapenee. Se näyttää, mitä kortteja muutos koskee ja mitä tehdä, kun forkin päivämäärää ei vielä ole.
Lyhyesti
- Pearl-louhinta siirtyy kokonaislukulaskennasta (INT7) 8-bittiseen liukulukuun (FP8), lukumuotoon, jossa tekoälymallit toimivat.
- Luonnoksen mukaan forkin jälkeen voivat louhia vain NVIDIA Hopper- ja Blackwell-GPU:t. GeForce RTX 40-, RTX 30- ja RTX 20 -kortit eivät voi, eikä mikään AMD:n tai Intelin GPU.
- Forkkilohkoa ei ole asetettu. Uusin Pearl-julkaisu, v1.5.5 28. lokakuuta 2026, ei sisällä FP8-koodia.
- Ennen kuin julkaisu nimeää forkkilohkon, mikään ei muutu. Jatka louhintaa kuten nytkin.
Mitä Pearl-louhijat laskevat nykyään
Pearl käyttää Proof of Useful Work (PoUW) -menetelmää. Satunnaislukujen hashaamisen sijaan louhija tekee työtä, josta on hyötyä myös ketjun ulkopuolella. Tässä se työ on matriisikertolasku, vaihe, johon tekoälyn koulutus ja päättely käyttävät suurimman osan ajastaan.
Matriiseihin lisätään satunnaista kohinaa, jotta tulosta ei voi arvata. Tulo pilkotaan pieniin paloihin, joita kutsutaan ruuduiksi. Jokaisesta ruudusta tulee luku, joka toimii kuin arpalippu.
Poolin tavoitteen alittava lippu lasketaan shareksi. Verkon paljon vaikeamman tavoitteen alittava lippu on lohko. Nollatietotodistus, lyhyt todiste siitä, että laskenta tehtiin oikein, antaa jokaisen noden tarkistaa työn edullisesti.
Nykyään matriisien arvot ovat 8-bittisiä kokonaislukuja, joissa on yhden bitin varmuusvara. Määrittely kutsuu tätä nimellä INT7. Tulot lasketaan yhteen 32-bittisiksi kokonaisluvuiksi (INT32).
Kokonaislukulaskenta antaa saman vastauksen jokaisella sirulla. Se on yksi syy siihen, että Pearlia voi nykyään louhia NVIDIA RTX 20 -sarjan ja uudemmilla korteilla. Louhintaohjelmasta riippuen se toimii myös AMD:n ja Intelin GPU:illa.
Mitä PIP-3 muuttaa
PIP-3:n otsikko on FP PoUW Certificates. Pearl-tiimi julkaisi sen 30. heinäkuuta 2026 tilalla Draft. Se korvaa kokonaislukujärjestelmän liukulukujärjestelmällä.
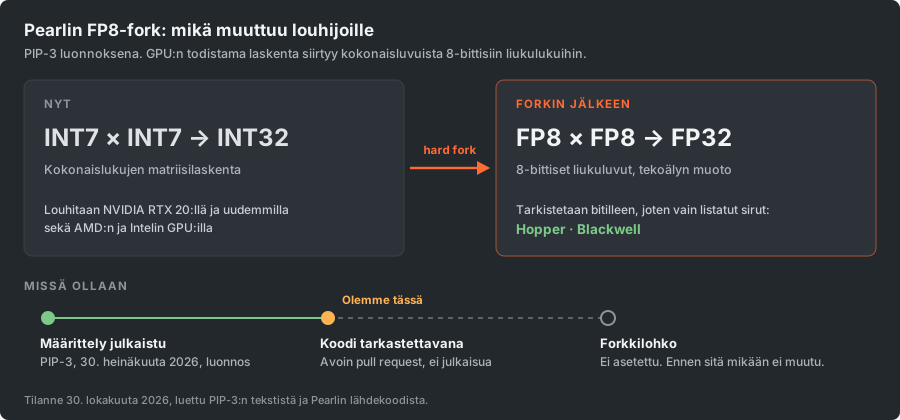
FP8 on luku, joka mahtuu 8 bittiin. Toisin kuin kokonaisluku, se voi esittää myös murtolukuja. PIP-3 käyttää E4M3-muotoa: yksi etumerkkibitti, neljä eksponenttibittiä ja kolme mantissabittiä.
Eksponenttibitit määräävät luvun suuruuden, ja mantissabitit määräävät sen tarkkuuden. Suurin E4M3-arvo on 448. Tulot lasketaan yhteen 32-bittisinä liukulukuina (FP32).
Jokainen matriisin rivi saa lisäksi oman skaalauskertoimensa. Se pitää rivin luvut pienen FP8-alueen sisällä.
| Mikä muuttuu | Nykyään | FP8-forkin jälkeen, luonnoksen mukaan |
|---|---|---|
| Lukumuoto | INT7, 8-bittinen kokonaisluku | FP8, E4M3-muoto |
| Tulot lasketaan yhteen muodossa | INT32, 32-bittinen kokonaisluku | FP32, 32-bittinen liukuluku |
| Sama vastaus jokaisella sirulla | Kyllä | Ei, vain yhden siruperheen sisällä |
| GPU:t, jotka voivat louhia | NVIDIA RTX 20 ja uudemmat; AMD ja Intel louhintaohjelmasta riippuen | Vain NVIDIA Hopper ja Blackwell |
Ehdotus perustelee muutosta hyödyllisyydellä. Lähes kaikki tekoälymallit ovat luonteeltaan liukulukulaskentaa. Todellinen päättely kertoo jo nyt FP8:lla ja säilyttää tulokset FP32:na.
Samaan vaiheeseen rakennettu todiste voi kulkea todellisen mallityön mukana. Ehdotus kutsuu tätä lähes täydelliseksi kaksi yhden hinnalla -tilanteeksi.
Kehityshaaran referenssilouhintaohjelma näyttää idean käytännössä. Se on vLLM-mallipalvelimen lisäosa, ja se louhii samalla, kun GPU ajaa tekoälymallia.
Ehdotus kertoo hinnasta avoimesti. Liukulukutulokset eivät ole bitilleen samoja kuin ideaalinen vastaus, joten tulos on hieman häviöllinen. Tiimi kertoo, ettei sen testaamien mallien tarkkuudessa näkynyt huomattavaa muutosta.
Liukulukutulokset eroavat myös siruperheiden välillä. Siitä päästään louhijoille tärkeimpään osaan.
Miksi GPU-lista lyhenee
Kaksi GPU-perhettä voi kertoa samat FP8-matriisit ja silti erota viimeisessä bitissä. Kumpikin perhe laskee luvut yhteen ja pyöristää ne omalla tavallaan.
Pearlille se on todellinen ongelma, koska verkko ei voi hyväksyä tulosta, joka on vain lähellä. Ehdotus selittää syyn. Mikä tahansa toleranssi tarkistuksessa antaisi louhijan säätää tulosta ja kerätä ylimääräisiä arpalippuja ilman lisätyötä.
Siksi tarkistuksen on toistettava louhijan laskenta täsmälleen.
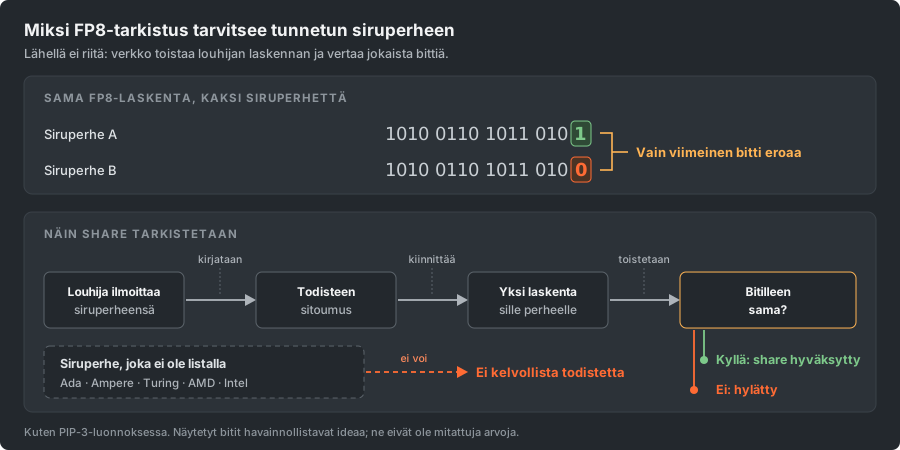
Jotta se olisi mahdollista, louhija ilmoittaa siruperheensä etukäteen. Perhe kirjoitetaan sitoumukseen, jonka varaan jokainen todiste rakennetaan. Louhija ja tarkistaja noudattavat sitten yhtä kiinteää laskentaa kyseiselle perheelle.
Vain sallittujen listalla olevia perheitä voi ilmoittaa, ja PIP-3 listaa kaksi: Hopper ja Blackwell. Minkään muun perheen kortilla ei ole pätevää tapaa todistaa työtään. Se pätee riippumatta siitä, kuinka nopea kortti on FP8-laskennassa.
Mitkä GPU:t jatkavat louhintaa ja mitkä eivät
Kehityshaaran referenssilouhintaohjelma käynnistyy alla luetelluilla siruilla. Millään muulla se kieltäytyy käynnistymästä.
Etkö ole varma, mihin perheeseen korttisi kuuluu? NVIDIAn CUDA-GPU-lista kertoo jokaisen kortin compute capability -arvon. 9.0 on Hopper, 10.0 ja suurempi on Blackwell, ja 8.9 on Ada.
| GPU-perhe | Esimerkkikortit | Forkin jälkeen, luonnoksen mukaan |
|---|---|---|
| Hopper | H100, H200 | Jatkaa louhintaa |
| Blackwell | B200, RTX PRO 6000, GeForce RTX 50 -sarja | Jatkaa louhintaa |
| Ada | GeForce RTX 40 -sarja, L40S | Lopettaa forkkilohkossa |
| Ampere | GeForce RTX 30 -sarja, A100 | Lopettaa forkkilohkossa |
| Turing | GeForce RTX 20 -sarja | Lopettaa forkkilohkossa |
| AMD ja Intel | Kaikki mallit | Lopettaa forkkilohkossa |
Yksi varaus GeForce RTX 50 -korttien omistajille. Referenssilouhintaohjelman omien muistiinpanojen mukaan sen testit ajetaan B200:lla.
Samojen muistiinpanojen mukaan yhdelle ruutumuodolle ei ole vielä kerneliä RTX 50 -korteilla. Siksi kerrokset, joita vain sillä muodolla voi louhia, jätetään pois. Yksikään julkaistu testi ei toistaiseksi näytä FP8-louhintaa GeForce RTX 50 -kortilla.
Erillinen ongelma koskee nykyistä virallista louhintaohjelmaa päähaarassa. Se on rakennettu vain Hopper-siruille. Kaksi avointa raporttia näyttää sen epäonnistuvan RTX 50 -korteilla: ei kerneliä RTX 50:lle ja GEMM-virhe RTX 5070:llä.
Kahta asiaa ei vielä tiedetä. Kukaan ei ole julkaissut, kuinka paljon GPU-muistia uusi järjestelmä vaatii tietyllä kortilla. Kukaan ei myöskään osaa vielä sanoa, tukevatko nykyiset louhintaohjelmat sitä.
Luonnos vaatii jokaista louhijaa noudattamaan referenssilaskentaa täsmälleen. Siksi jokaisen ohjelman, joka haluaa louhia forkin jälkeen, on vastattava sitä bitilleen.
Mikä luonnoksessa on vielä auki
PIP-3 on luonnos, ja teksti sanoo sen useassa kohdassa. Nämä osat on yhä merkitty päätettäviksi ennen kuin ehdotus siirtyy seuraavaan tilaan:
- Tiivis muoto, jossa matriisit voidaan tallentaa ennen kuin ne muunnetaan FP8:ksi.
- Tilastolliset tarkistukset, jotka voittavan ruudun on läpäistävä.
- Testivektorit ja julkaistut kokeet.
- Linkki referenssilouhintaohjelmaan.
- Käyttöönottosuunnitelma.
Kehityskoodi on myös paikoin edennyt tekstiä pidemmälle. Esimerkiksi se käsittelee jo mixture of experts -kerroksia. Se on tekoälymallin rakenne, jossa jokaista syötettä varten ajetaan vain osa mallista.
Se myös numeroi sertifikaatin version eri tavalla. Se on luonnokselle normaalia. Mutta se tarkoittaa, että yksityiskohdat voivat vielä muuttua, myös se, mikä laitteisto hyväksytään.
Milloin se tapahtuu
Päivämäärää ei ole. Pearlin fork aktivoituu node-ohjelmistoon kirjoitetulla lohkokorkeudella. Tälle forkille ei ole mainnetin korkeutta.
Tarkastettavana olevassa koodissa forkin korkeus on asetettu vain kehittäjien käyttämille paikallisille testiverkoille. Uusin Pearl-julkaisu, v1.5.5 28. lokakuuta 2026 ei sisällä lainkaan FP8-koodia. Kun julkaisu asettaa korkeuden, se luku kannattaa merkitä muistiin.
Pearl on muuttanut konsensustaan useita kertoja aiemmin. Jokainen näistä muutoksista aktivoitui kiinteässä lohkossa, joka oli nimetty julkaisussa. Louhija, joka tietää lohkon numeron ja päivittää ennen sitä, ei menetä mitään.
Mitä tehdä nyt
- Jatka louhintaa. Louhintaohjelmasi, asetuksesi ja tilityksesi toimivat täsmälleen kuten ennenkin forkkilohkoon asti. Älä muuta mitään luonnoksen takia.
- Etsi korttisi perhe yllä olevasta taulukosta tai sen compute capability -arvon perusteella NVIDIAn listalta.
- Jos korttisi on Hopper tai Blackwell, suunnittele asentavasi FP8-järjestelmää tukeva louhintaohjelma ennen forkkilohkoa, kun sellainen on olemassa.
- Jos korttisi on jokin muu, jatka Pearlin louhintaa forkkilohkoon asti. Valitse jo nyt, mitä kolikkoa kortti louhii sen jälkeen. Parhaiden louhinta-GPU:iden lista ja louhintalaskuri näyttävät, mitä korttisi ansaitsee muilla kolikoilla.
- Seuraa Pearlin julkaisusivua ja Pearlin ehdotusrepositoriota forkin korkeuden varalta.
- Forkkipäivänä arvioi louhintaohjelmaasi sen poolissa hyväksyttyjen sharejen perusteella, älä sen näyttämän hashraten perusteella. Vanhentunut louhintaohjelma voi raportoida tervettä hashratea, vaikka mikään sen työstä ei laske.
Harkitsetko laitteiston ostamista Pearlia varten? Osta sen mukaan, mitä verkko hyväksyy tänään ja mitä lopullinen versio hyväksyy. Älä osta luonnoksen mukaan, joka voi vielä muuttua.
Usein kysytyt kysymykset
Louhiiko RTX 4090 Pearlia vielä FP8-forkin jälkeen?
Ei siinä muodossa, jossa PIP-3 on nyt kirjoitettu. RTX 4090 on Ada-kortti, eikä Ada ole luonnoksen siruperheiden listalla. Näin on, vaikka kortti osaa FP8-laskennan laitteistotasolla. Se louhii Pearlia normaalisti forkkilohkoon asti.
Jatkaako RTX 5090 Pearlin louhintaa?
Luonnoksen mukaan kyllä. GeForce RTX 50 -sarja on Blackwell, ja kehityshaaran referenssilouhintaohjelma käynnistyy sillä. Yksikään julkaistu testi ei vielä näytä FP8-louhintaa GeForce RTX 50 -kortilla.
Voivatko AMD:n tai Intelin GPU:t louhia Pearlia forkin jälkeen?
Eivät luonnoksen mukaan. Luonnos hyväksyy vain NVIDIA Hopperin ja Blackwellin. AMD:n ja Intelin kortit voivat louhia Pearlia nyt louhintaohjelmasta riippuen. Ne jatkavat sitä forkkilohkoon asti.
Miksi nopea RTX 4090 ei voi louhia FP8-Pearlia?
Nopeus ei ole ongelma. Jokainen siruperhe pyöristää liukulukulaskennan hieman eri tavalla. Verkon on toistettava louhijan tulos bitilleen. Se vaatii yhden kiinteän, sovitun laskennan perhettä kohden, ja luonnos määrittelee sellaisen vain Hopperille ja Blackwellille.
Milloin Pearlin FP8-fork tapahtuu?
Päivämäärää tai lohkokorkeutta ei ole asetettu. Uusin julkaisu, v1.5.5 28. lokakuuta 2026, ei sisällä FP8-koodia. Korkeus nimetään julkaisussa, kun se on valittu.
Pitääkö minun tehdä jotain nyt?
Ei. Jatka louhintaa kuten nytkin. Toimi, kun julkaisu nimeää forkkilohkon. Päivitä louhintaohjelmasi, jos korttisi on Hopper tai Blackwell, tai siirrä kortti toiselle kolikolle, jos se ei ole.
Mistä nämä tiedot ovat peräisin
Jokaisen väitteen voi tarkistaa. Järjestelmä, sen perustelut, laitteiston sallittujen lista ja avoimet kohdat ovat peräisin PIP-3:n tekstistä. Se on Pearl-tiimin julkisessa ehdotusrepositoriossa.
GPU-tuki on peräisin Pearl-repositorion FP8-kehityshaaran referenssilouhintaohjelmasta. Ohjelma kertoo itse, millä siruilla se käynnistyy.
Aktivoinnin tila on peräisin saman koodin verkkoparametreista. Niissä FP8-forkin korkeus on asetettu vain testiverkoille. Tieto tulee myös uusimmasta julkaisusta.
Kun lähteet eivät sano mitään, kuten muistitarpeesta tai tuesta muissa louhintaohjelmissa, tämä kirjoitus kertoo sen. Se ei arvaa.