






A Pearl FP8 fork röviden: mely GPU-k bányásznak tovább
A Pearl (PRL) az indulása óta legnagyobb változására készül. Egy PIP-3 nevű javaslat a Pearl-bányászatot az egész számos számításról FP8-ra állítja át. Az FP8 az a 8 bites lebegőpontos formátum, amelyben a modern MI-modellek futnak.
A változás hard fork, ezért minden node-ot frissíteni kell. A mai szöveg szerint a bányászatra képes videokártyák listáját is lerövidíti.
Ez a cikk elmagyarázza, mi változik, és miért szűkül a hardverlista. Megmutatja, mely kártyákat érinti, és mit érdemes tenni, amíg nincs fork dátum.
Röviden
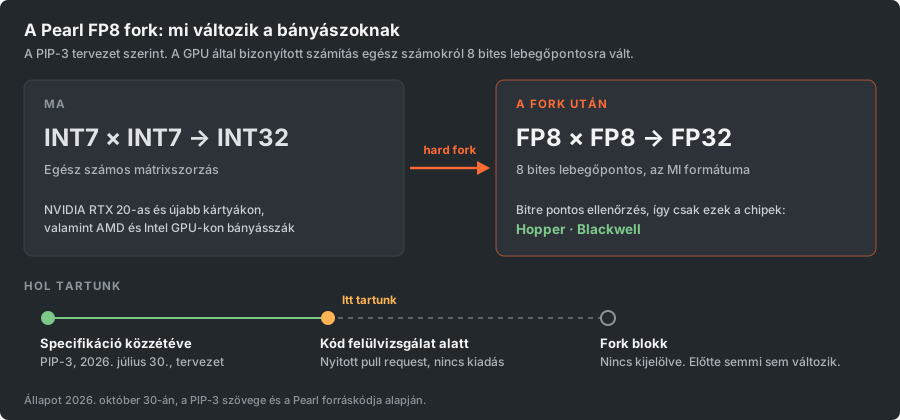
- A Pearl-bányászat az egész számos számításról (INT7) a 8 bites lebegőpontos számításra (FP8) vált, arra a számformátumra, amelyben az MI-modellek futnak.
- A tervezet szerint a fork után csak az NVIDIA Hopper és Blackwell GPU-k bányászhatnak. A GeForce RTX 40, RTX 30 és RTX 20 kártyák nem, és egyetlen AMD vagy Intel GPU sem.
- Nincs kijelölt fork blokk. A legújabb Pearl kiadás, a 2026. október 28-i v1.5.5 nem tartalmaz FP8-kódot.
- Amíg egy kiadás nem jelöl ki fork blokkot, semmi sem változik. Bányásszon tovább úgy, ahogy ma.
Mit számolnak ma a Pearl-bányászok
A Pearl a Proof of Useful Work (PoUW) módszert használja. Véletlen számok hashelése helyett a bányász a láncon kívül is hasznos munkát végez. Ez a munka itt a mátrixszorzás, az a lépés, amellyel az MI-tanítás és -következtetés ideje nagy részét tölti.
A mátrixokhoz véletlen zajt adnak, hogy az eredményt ne lehessen kitalálni. A szorzatot kis blokkokra, úgynevezett csempékre vágják. Minden csempéből egy szám lesz, amely sorsjegyként működik.
A pool célértéke alatti sorsjegy részesedésnek számít. A sokkal nehezebb hálózati célérték alatti sorsjegy blokk. Egy zero-knowledge bizonyítás, vagyis egy rövid bizonyíték arra, hogy a számítás helyes, lehetővé teszi, hogy minden node olcsón ellenőrizze a munkát.
Ma a mátrixértékek 8 bites egész számok egy bit tartalékkal. A specifikáció ezt INT7-nek nevezi. A szorzatok 32 bites egész számokba (INT32) összegződnek.
Az egész számos számítás minden chipen ugyanazt az eredményt adja. Ez az egyik oka annak, hogy a Pearl ma bányászható az NVIDIA RTX 20-as és újabb sorozatú kártyákon. A bányászprogramtól függően AMD és Intel GPU-kon is fut.
Mit változtat a PIP-3
A PIP-3 címe FP PoUW Certificates. A Pearl csapata 2026. július 30-án tette közzé Draft (tervezet) státusszal. Az egész számos sémát lebegőpontosra cseréli.
Az FP8 olyan szám, amely 8 bitbe fér. Az egész számmal ellentétben törteket is tárolhat. A PIP-3 az E4M3 elrendezést használja: egy előjelbit, négy kitevőbit és három mantisszabit.
A kitevőbitek a szám nagyságát adják meg, a mantisszabitek a pontosságát. A legnagyobb E4M3 érték 448. A szorzatok 32 bites lebegőpontos számokban (FP32) összegződnek.
A mátrix minden sora saját skálázási tényezőt is kap. Így a számai beférnek az FP8 szűk tartományába.
| Mi változik | Ma | Az FP8 fork után, a tervezet szerint |
|---|---|---|
| Számformátum | INT7, 8 bites egész szám | FP8, E4M3 elrendezés |
| A szorzatok összegzése | INT32, 32 bites egész szám | FP32, 32 bites lebegőpontos |
| Ugyanaz az eredmény minden chipen | Igen | Nem, csak egy chipcsaládon belül |
| Bányászatra képes GPU-k | NVIDIA RTX 20 és újabb; AMD és Intel, a bányászprogramtól függően | Csak NVIDIA Hopper és Blackwell |
A javaslat a hasznosságot adja meg okként. Szinte minden MI-modell természeténél fogva lebegőpontos. A valódi következtetés már ma is FP8-ban szoroz, és FP32-ben tartja az eredményeket.
Az ugyanerre a lépésre épülő bizonyítás együtt haladhat a valódi modellmunkával. A javaslat ezt szinte tökéletes kettő az egyben megoldásnak nevezi.
A fejlesztési ágon lévő referencia-bányász a gyakorlatban is megmutatja az ötletet. Ez egy bővítmény a vLLM modellszerverhez, és bányászik, miközben a GPU egy MI-modellt szolgál ki.
A javaslat nyíltan beszél az árról. A lebegőpontos eredmények nem bitre azonosak az ideális válasszal, így a kimenet kissé veszteséges. A csapat szerint a tesztelt modelleken nem változott érezhetően a pontosság.
A lebegőpontos eredmények chipcsaládonként is eltérnek. Ez vezet ahhoz a részhez, amely a bányászoknak a legfontosabb.
Miért rövidül a GPU-lista
Két GPU-család összeszorozhatja ugyanazokat az FP8-mátrixokat, és mégis eltérhet az utolsó bitben. Minden család a maga módján összegzi és kerekíti a számokat.
A Pearlnek ez valódi gond, mert a hálózat nem fogadhat el olyan eredményt, amely csak közel van. A javaslat elmagyarázza, miért. Az ellenőrzés bármilyen tűréshatára lehetővé tenné, hogy egy bányász kicsit eltolja a kimenetet, és plusz munka nélkül plusz sorsjegyeket gyűjtsön.
Ezért az ellenőrzésnek pontosan meg kell ismételnie a bányász számítását.
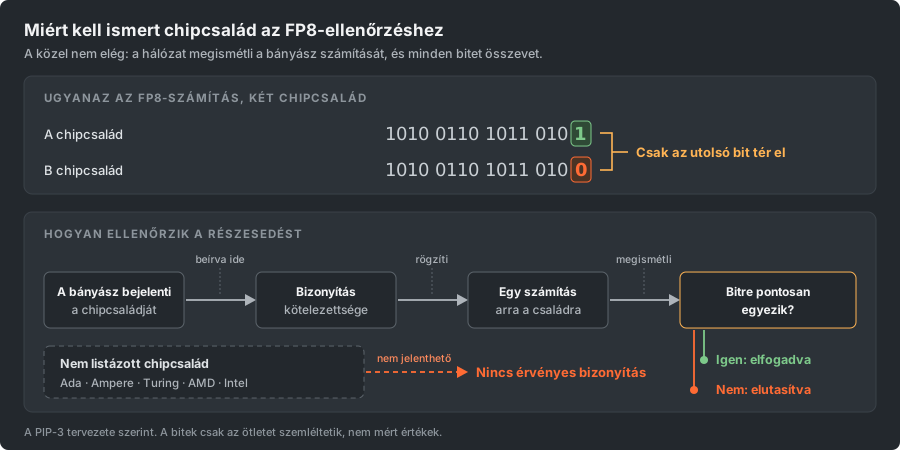
Hogy ez lehetséges legyen, a bányász előre bejelenti a chipcsaládját. A család bekerül abba a kötelezettségvállalásba, amelyre minden bizonyítás épül. A bányász és az ellenőrző ezután ugyanazt a rögzített számítást követi az adott családra.
Csak egy engedélyezési listán szereplő családok jelenthetők be, és a PIP-3 kettőt sorol fel: Hopper és Blackwell. Bármely más család kártyájának nincs érvényes módja a munkája bizonyítására. Ez akkor is így van, ha a kártya nagyon gyors FP8-ban.
Mely GPU-k bányásznak tovább, és melyek nem
A fejlesztési ágon lévő referencia-bányász az alábbi chipeken indul el. Minden máson megtagadja az indulást.
Nem tudja, melyik családba tartozik a kártyája? Az NVIDIA CUDA GPU-listája megadja minden kártya compute capability értékét. A 9.0 Hopper, a 10.0 és afölött Blackwell, a 8.9 pedig Ada.
| GPU-család | Példakártyák | A fork után, a tervezet szerint |
|---|---|---|
| Hopper | H100, H200 | Tovább bányászik |
| Blackwell | B200, RTX PRO 6000, GeForce RTX 50 sorozat | Tovább bányászik |
| Ada | GeForce RTX 40-es sorozat, L40S | A fork blokknál leáll |
| Ampere | GeForce RTX 30-as sorozat, A100 | A fork blokknál leáll |
| Turing | GeForce RTX 20-as sorozat | A fork blokknál leáll |
| AMD és Intel | Minden modell | A fork blokknál leáll |
Egy figyelmeztetés a GeForce RTX 50 tulajdonosainak. A referencia-bányász saját leírása szerint a tesztjei B200-on futnak.
Ugyanez a leírás azt mondja, hogy az egyik csempeformához még nincs kernel az RTX 50 kártyákon. Így azok a rétegek kimaradnak, amelyeket csak ez a forma tud bányászni. Eddig egyetlen közzétett teszt sem mutat FP8-bányászatot GeForce RTX 50 kártyán.
Van egy külön probléma is a fő ágon lévő mai hivatalos bányászprogrammal. Ez csak Hopper chipekre készült. Két nyitott hibajegy mutatja, hogy RTX 50 kártyákon hibára fut: nincs kernel az RTX 50-hez és GEMM-hiba az RTX 5070-en.
Két dolog még nem ismert. Senki sem tette közzé, mennyi GPU-memóriát igényel az új séma egy adott kártyán. Azt sem tudja még senki, hogy a mai bányászprogramok támogatni fogják-e.
A tervezet megköveteli, hogy minden bányász pontosan a referenciaszámítást kövesse. Így minden programnak, amely a fork után bányászni akar, bitre pontosan egyeznie kell vele.
Mi nyitott még a tervezetben
A PIP-3 tervezet, és a szöveg ezt több helyen ki is mondja. Ezek a részek még eldöntendőként vannak jelölve, mielőtt a javaslat a következő státuszba lép:
- A tömör formátum, amelyben a mátrixokat tárolhatják, mielőtt FP8-ra alakítják őket.
- A statisztikai ellenőrzések, amelyeken egy nyertes csempének át kell mennie.
- A tesztvektorok és a közzétett kísérletek.
- A hivatkozás a referencia-bányászra.
- A bevezetési terv.
A fejlesztési kód helyenként már túl is lépett a szövegen. Például már kezeli a mixture of experts rétegeket. Ez az a modellfelépítés, amelyben minden bemenetre csak a modell egy része fut.
A tanúsítvány verzióját is másképp számozza. Ez egy tervezetnél normális. Azt jelenti viszont, hogy a részletek még változhatnak, köztük az is, hogy milyen hardvert fogad el a hálózat.
Mikor történik meg
Nincs dátum. Egy Pearl fork a node-szoftverbe írt blokkmagasságnál aktiválódik. Ehhez a forkhoz nincs mainnet magasság.
Az ellenőrzés alatt álló kódban a fork magassága csak a fejlesztők helyi teszthálózataihoz van megadva. A legújabb Pearl kiadás, a v1.5.5 2026. október 28-ról egyáltalán nem tartalmaz FP8-kódot. Amikor egy kiadás magasságot ad meg, azt a számot érdemes feljegyezni.
A Pearl már többször módosította a konszenzusát. Minden ilyen változás egy rögzített blokknál aktiválódott, amelyet egy kiadás megnevezett. Az a bányász, aki ismeri a blokk számát, és előtte frissít, nem veszít semmit.
Mit tegyen most
- Bányásszon tovább. A bányászprogramja, a beállításai és a kifizetései a fork blokkig pontosan úgy működnek, mint eddig. Egy tervezet miatt ne változtasson semmin.
- Keresse meg a kártyája családját a fenti táblázatban, vagy a compute capability értéke alapján az NVIDIA listáján.
- Hopper vagy Blackwell kártyán tervezze be, hogy a fork blokk előtt telepít egy FP8-sémát támogató bányászprogramot, amint lesz ilyen.
- Bármely más kártyán bányásszon Pearlt a fork blokkig. Már most döntse el, melyik érmét bányássza majd utána a kártya. A legjobb bányász GPU-k listája és a bányászati kalkulátor megmutatja, mennyit keres a kártyája más érméken.
- Figyelje a Pearl kiadási oldalát és a Pearl javaslattárát a fork magasságáért.
- A fork napján a bányászprogramját a poolon elfogadott részesedések alapján ítélje meg, ne a kiírt hashráta alapján. Egy elavult program egészséges hashrátát mutathat, miközben a munkájából semmi sem számít.
Hardvert venne a Pearlhöz? Arra vásároljon, amit a hálózat ma elfogad, és amit a végleges változat elfogad. Ne egy tervezetre vásároljon, amely még változhat.
Gyakran ismételt kérdések
Bányászik még Pearlt az RTX 4090 az FP8 fork után?
A PIP-3 mai szövege szerint nem. Az RTX 4090 Ada kártya, és az Ada nincs a tervezet chipcsaládjainak listáján. Ez akkor is így van, ha hardveresen tud FP8-számítást végezni. A fork blokkig normálisan bányászik Pearlt.
Bányászik tovább Pearlt az RTX 5090?
A tervezet szerint igen. A GeForce RTX 50 sorozat Blackwell, és a fejlesztési ágon lévő referencia-bányász elindul rajta. Közzétett teszt még nem mutat FP8-bányászatot GeForce RTX 50 kártyán.
Bányászhatnak Pearlt AMD vagy Intel GPU-k a fork után?
A tervezet szerint nem. A tervezet csak az NVIDIA Hopper és Blackwell kártyákat fogadja el. Az AMD és Intel kártyák ma bányászhatnak Pearlt, a bányászprogramtól függően. Ezt a fork blokkig folytathatják.
Miért nem bányászhat egy gyors RTX 4090 FP8-as Pearlt?
Nem a sebesség a gond. Minden chipcsalád kissé másképp kerekíti a lebegőpontos számításokat. A hálózatnak bitre pontosan meg kell ismételnie a bányász eredményét. Ehhez családonként egy rögzített, közösen elfogadott számítás kell, és a tervezet csak a Hopperhez és a Blackwellhez határoz meg ilyet.
Mikor lesz a Pearl FP8 fork?
Sem dátum, sem blokkmagasság nincs kijelölve. A legújabb kiadás, a 2026. október 28-i v1.5.5 nem tartalmaz FP8-kódot. Amint kiválasztanak egy magasságot, egy kiadás megnevezi.
Kell ma tennem valamit?
Nem. Bányásszon tovább úgy, mint most. Akkor lépjen, amikor egy kiadás megnevezi a fork blokkot. Frissítse a bányászprogramot, ha a kártyája Hopper vagy Blackwell, vagy állítsa át a kártyát egy másik érmére, ha nem az.
Honnan származnak ezek a tények
Minden állítás ellenőrizhető. A séma, a motivációja, a hardveres engedélyezési lista és a nyitott pontok a PIP-3 szövegéből származnak. Ez a Pearl csapatának nyilvános javaslattárában található.
A GPU-támogatás a Pearl tárolójának FP8 fejlesztési ágán lévő referencia-bányászból származik. Ez a bányász megadja, mely chipeken indul el.
Az aktiválás állapota ugyanennek a kódnak a hálózati paramétereiből származik. Ott az FP8 fork magassága csak a teszthálózatokhoz van megadva. A legújabb kiadás is ezt mutatja.
Ahol a források semmit sem mondanak, például a memóriaigényről vagy más bányászprogramok támogatásáról, ezt a cikk kimondja. Nem találgat.