






Pearl-ის FP8 ფორკი: რომელი GPU-ები გააგრძელებს მაინინგს
Pearl (PRL) გაშვების შემდეგ ყველაზე დიდი ცვლილებისთვის ემზადება. წინადადება სახელად PIP-3 Pearl-ის მაინინგს მთელი რიცხვების მათემატიკიდან FP8-ზე გადაიტანს. FP8 არის 8-ბიტიანი მცურავი მძიმის ფორმატი, რომელზეც თანამედროვე ხელოვნური ინტელექტის მოდელები მუშაობს.
ეს ცვლილება ჰარდფორკია, ამიტომ ყველა ნოდი უნდა განახლდეს. დღევანდელი ფორმულირებით ის ასევე ამოკლებს იმ ვიდეობარათების სიას, რომლებსაც მაინინგი შეუძლიათ.
ეს სტატია განმარტავს, რა იცვლება და რატომ მცირდება აპარატურის სია. ის აჩვენებს, რომელ ბარათებს ეხება ცვლილება და რა უნდა გააკეთოთ, სანამ ფორკის თარიღი არ არსებობს.
მოკლედ
- Pearl-ის მაინინგი მთელი რიცხვების მათემატიკიდან (INT7) 8-ბიტიან მცურავ მძიმეზე (FP8) გადადის, რიცხვების იმ ფორმატზე, რომელზეც ხელოვნური ინტელექტის მოდელები მუშაობს.
- მონახაზის მიხედვით ფორკის შემდეგ მაინინგს მხოლოდ NVIDIA Hopper და Blackwell GPU-ები შეძლებენ. GeForce RTX 40, RTX 30 და RTX 20 ბარათები ვერ შეძლებენ, ვერც AMD-ისა და Intel-ის რომელიმე GPU.
- ფორკის ბლოკი დადგენილი არ არის. Pearl-ის უახლესი რელიზი, 2026 წლის 28 ოქტომბრის v1.5.5, FP8-ის კოდს არ შეიცავს.
- სანამ რელიზი ფორკის ბლოკს არ დაასახელებს, არაფერი იცვლება. გააგრძელეთ მაინინგი ისე, როგორც დღეს.
რას ითვლიან Pearl-ის მაინერები დღეს
Pearl იყენებს Proof of Useful Work-ს (PoUW). შემთხვევითი რიცხვების ჰეშირების ნაცვლად მაინერი ასრულებს სამუშაოს, რომელიც ჯაჭვის გარეთაც სასარგებლოა. აქ ეს სამუშაო მატრიცების გამრავლებაა, ის ნაბიჯი, რომელზეც ხელოვნური ინტელექტის წვრთნა და ინფერენსი დროის უდიდეს ნაწილს ხარჯავს.
მატრიცებს ემატება შემთხვევითი ხმაური, რომ შედეგის გამოცნობა შეუძლებელი იყოს. ნამრავლი იჭრება პატარა ბლოკებად, რომლებსაც ფილები ჰქვია. ყოველი ფილა იქცევა რიცხვად, რომელიც ლატარიის ბილეთივით მუშაობს.
ბილეთი, რომელიც პულის სამიზნეზე დაბლაა, შეარად ითვლება. ბილეთი, რომელიც ქსელის გაცილებით რთულ სამიზნეზე დაბლაა, ბლოკია. ნულოვანი ცოდნის მტკიცებულება, ანუ მოკლე მტკიცებულება იმისა, რომ გამოთვლა სწორად შესრულდა, ყველა ნოდს საშუალებას აძლევს, სამუშაო იაფად შეამოწმოს.
დღეს მატრიცის მნიშვნელობები 8-ბიტიანი მთელი რიცხვებია ერთი ბიტის მარაგით. სპეციფიკაცია მათ INT7-ს უწოდებს. ნამრავლები 32-ბიტიან მთელ რიცხვებში (INT32) იკრიბება.
მთელი რიცხვების მათემატიკა ყველა ჩიპზე ერთსა და იმავე პასუხს იძლევა. ეს ერთ-ერთი მიზეზია, რის გამოც Pearl-ის მაინინგი დღეს შესაძლებელია NVIDIA RTX 20 სერიისა და უფრო ახალ ბარათებზე. მაინინგის პროგრამის მიხედვით ის AMD-ისა და Intel-ის GPU-ებზეც მუშაობს.
რას ცვლის PIP-3
PIP-3 სათაურია FP PoUW Certificates. Pearl-ის გუნდმა ის 2026 წლის 30 ივლისს გამოაქვეყნა სტატუსით „მონახაზი“. ის მთელი რიცხვების სქემას მცურავი მძიმის სქემით ცვლის.
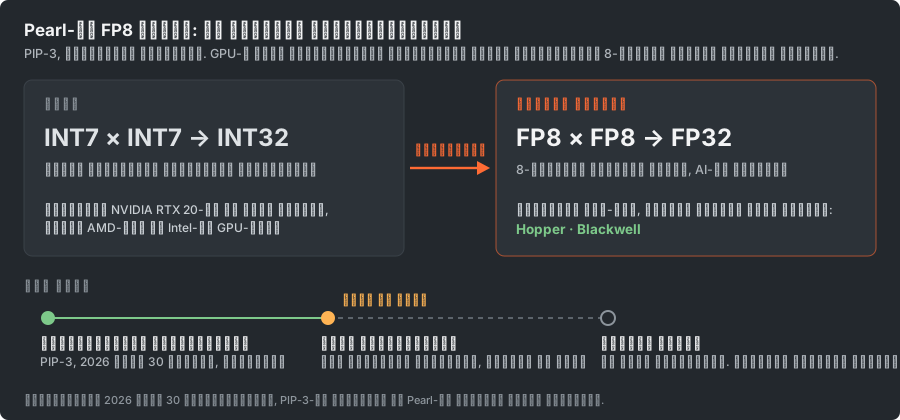
FP8 არის რიცხვი, რომელიც 8 ბიტში ეტევა. მთელი რიცხვისგან განსხვავებით, მას წილადის შენახვაც შეუძლია. PIP-3 იყენებს E4M3 განლაგებას: ერთი ნიშნის ბიტი, ექსპონენტის ოთხი ბიტი და მანტისის სამი ბიტი.
ექსპონენტის ბიტები რიცხვის სიდიდეს ადგენს, მანტისის ბიტები კი მის სიზუსტეს. E4M3-ის უდიდესი მნიშვნელობა 448-ია. ნამრავლები 32-ბიტიან მცურავ მძიმეში (FP32) იკრიბება.
მატრიცის ყოველ სტრიქონს ასევე საკუთარი მასშტაბის კოეფიციენტი აქვს. ის სტრიქონის რიცხვებს FP8-ის მცირე დიაპაზონში ინარჩუნებს.
| რა იცვლება | დღეს | FP8 ფორკის შემდეგ, მონახაზის მიხედვით |
|---|---|---|
| რიცხვის ფორმატი | INT7, 8-ბიტიანი მთელი რიცხვი | FP8, E4M3 განლაგება |
| ნამრავლები იკრიბება | INT32-ში, 32-ბიტიან მთელ რიცხვში | FP32-ში, 32-ბიტიან მცურავ მძიმეში |
| ერთი პასუხი ყველა ჩიპზე | დიახ | არა, მხოლოდ ერთი ჩიპების ოჯახის შიგნით |
| GPU-ები, რომლებსაც მაინინგი შეუძლიათ | NVIDIA RTX 20 და უფრო ახალი; AMD და Intel, მაინინგის პროგრამის მიხედვით | მხოლოდ NVIDIA Hopper და Blackwell |
წინადადება მიზეზად სარგებლიანობას ასახელებს. ხელოვნური ინტელექტის თითქმის ყველა მოდელი ბუნებით მცურავ მძიმეზეა. რეალური ინფერენსი უკვე FP8-ში ამრავლებს და შედეგებს FP32-ში ინახავს.
იმავე ნაბიჯზე აგებული მტკიცებულება შეიძლება მოდელის რეალურ სამუშაოს თან ახლდეს. წინადადება ამას თითქმის სრულყოფილ „ორს ერთის ფასად“ უწოდებს.
განვითარების ტოტზე არსებული საცნობარო მაინერი ამ იდეას პრაქტიკაში აჩვენებს. ის vLLM მოდელების სერვერის მოდულია და მაინინგს მაშინ აკეთებს, როცა GPU ხელოვნური ინტელექტის მოდელს ემსახურება.
წინადადება ფასზე გულწრფელად საუბრობს. მცურავი მძიმის შედეგები ბიტ-ბიტ არ ემთხვევა იდეალურ პასუხს, ამიტომ შედეგი მცირედ დანაკარგიანია. გუნდი იუწყება, რომ გამოცდილ მოდელებზე სიზუსტის შესამჩნევი ცვლილება არ უნახავს.
მცურავი მძიმის შედეგები ჩიპების ოჯახებს შორისაც განსხვავდება. ეს გვიყვანს იმ ნაწილამდე, რომელიც მაინერებისთვის ყველაზე მნიშვნელოვანია.
რატომ მცირდება GPU-ების სია
GPU-ების ორ ოჯახს შეუძლია ერთი და იგივე FP8 მატრიცები გაამრავლოს და მაინც ბოლო ბიტში განსხვავდებოდეს. თითოეული ოჯახი რიცხვებს თავისებურად კრებს და ამრგვალებს.
Pearl-ისთვის ეს რეალური პრობლემაა, რადგან ქსელს არ შეუძლია მიიღოს შედეგი, რომელიც მხოლოდ ახლოსაა. წინადადება ხსნის, რატომ. შემოწმებაში ნებისმიერი დაშვება მაინერს მისცემდა საშუალებას, შედეგი ოდნავ გადაეწია და მეტი სამუშაოს გარეშე დამატებითი ლატარიის ბილეთები შეეგროვებინა.
ამიტომ შემოწმებამ მაინერის გამოთვლა ზუსტად უნდა გაიმეოროს.
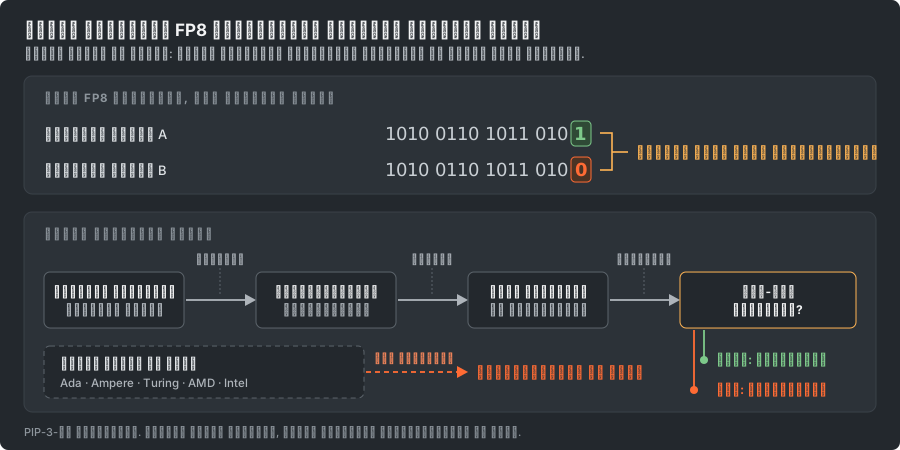
ამის შესაძლებლად მაინერი თავისი ჩიპების ოჯახს წინასწარ აცხადებს. ოჯახი ჩაიწერება ვალდებულებაში (commitment), რომელზეც ყოველი მტკიცებულებაა აგებული. შემდეგ მაინერიც და შემმოწმებელიც ამ ოჯახისთვის ერთ ფიქსირებულ გამოთვლას მიჰყვებიან.
გამოცხადება შეიძლება მხოლოდ თეთრ სიაში შეტანილი ოჯახებისა, და PIP-3 ორს ასახელებს: Hopper-სა და Blackwell-ს. სხვა ნებისმიერი ოჯახის ბარათს თავისი სამუშაოს დამტკიცების ვალიდური გზა არ აქვს. ეს ასეა, რაც არ უნდა სწრაფი იყოს ბარათი FP8-ში.
რომელი GPU-ები გააგრძელებენ მაინინგს და რომლები არა
განვითარების ტოტზე არსებული საცნობარო მაინერი ქვემოთ მოცემულ ჩიპებზე იტვირთება. ყველაფერ სხვაზე ის ჩატვირთვაზე უარს ამბობს.
არ იცით, რომელ ოჯახს ეკუთვნის თქვენი ბარათი? NVIDIA-ს CUDA GPU-ების სია თითოეული ბარათის გამოთვლით შესაძლებლობას (compute capability) აჩვენებს. 9.0 არის Hopper, 10.0 და მეტი არის Blackwell, ხოლო 8.9 არის Ada.
| GPU-ების ოჯახი | ბარათების მაგალითები | ფორკის შემდეგ, მონახაზით |
|---|---|---|
| Hopper | H100, H200 | აგრძელებს მაინინგს |
| Blackwell | B200, RTX PRO 6000, GeForce RTX 50 სერია | აგრძელებს მაინინგს |
| Ada | GeForce RTX 40 სერია, L40S | ჩერდება ფორკის ბლოკზე |
| Ampere | GeForce RTX 30 სერია, A100 | ჩერდება ფორკის ბლოკზე |
| Turing | GeForce RTX 20 სერია | ჩერდება ფორკის ბლოკზე |
| AMD და Intel | ყველა მოდელი | ჩერდება ფორკის ბლოკზე |
ერთი შენიშვნა GeForce RTX 50-ის მფლობელებისთვის. საცნობარო მაინერის საკუთარი ჩანაწერები ამბობს, რომ მისი ტესტები B200-ზე ეშვება.
იგივე ჩანაწერები ამბობს, რომ ფილის ერთ ფორმას RTX 50 ბარათებზე ჯერ ბირთვი (kernel) არ აქვს. ამიტომ ფენები, რომელთა მაინინგი მხოლოდ ამ ფორმით შეიძლება, გამოტოვებულია. ჯერჯერობით არცერთი გამოქვეყნებული ტესტი არ აჩვენებს FP8 მაინინგს GeForce RTX 50 ბარათზე.
ცალკე საკითხია დღევანდელი ოფიციალური მაინერი მთავარ ტოტზე. ის მხოლოდ Hopper ჩიპებისთვისაა აწყობილი. ორი ღია განაცხადი აჩვენებს, რომ ის RTX 50 ბარათებზე ვერ მუშაობს: ბირთვი RTX 50-ისთვის არ არის და GEMM-ის შეცდომა RTX 5070-ზე.
ორი რამ ჯერ უცნობია. არავის გამოუქვეყნებია, რამდენ GPU მეხსიერებას საჭიროებს ახალი სქემა კონკრეტულ ბარათზე. ჯერ ვერავინ იტყვის, დაუჭერენ თუ არა მხარს მას დღევანდელი მაინინგის პროგრამები.
მონახაზი მოითხოვს, რომ ყველა მაინერი საცნობარო გამოთვლას ზუსტად მიჰყვეს. ამიტომ ნებისმიერი პროგრამა, რომელსაც ფორკის შემდეგ მაინინგი სურს, მას ბიტ-ბიტ უნდა დაემთხვეს.
რა რჩება ღიად მონახაზში
PIP-3 მონახაზია და ტექსტიც ამას რამდენიმე ადგილას ამბობს. ეს ნაწილები ჯერ კიდევ მონიშნულია, როგორც გადასაწყვეტი, სანამ წინადადება შემდეგ სტატუსზე გადავა:
- კომპაქტური ფორმატი, რომელშიც მატრიცები შეიძლება ინახებოდეს FP8-ად გარდაქმნამდე.
- სტატისტიკური შემოწმებები, რომლებიც მომგებიანმა ფილამ უნდა გაიაროს.
- სატესტო ვექტორები და გამოქვეყნებული ექსპერიმენტები.
- ბმული საცნობარო მაინერზე.
- დანერგვის გეგმა.
განვითარების კოდი ზოგ ადგილას ტექსტს უკვე გაუსწრო. მაგალითად, ის უკვე ამუშავებს ექსპერტთა ნარევის ფენებს. ეს ხელოვნური ინტელექტის მოდელის ისეთი აგებულებაა, რომელშიც ყოველი შეყვანისთვის მოდელის მხოლოდ ნაწილი მუშაობს.
კოდი სერტიფიკატის ვერსიასაც სხვაგვარად ნომრავს. მონახაზისთვის ეს ჩვეულებრივია. მაგრამ ეს ნიშნავს, რომ დეტალები ჯერ კიდევ შეიძლება შეიცვალოს, მათ შორის ისიც, რომელი აპარატურა მიიღება.
როდის მოხდება
თარიღი არ არსებობს. Pearl-ის ფორკი აქტიურდება ბლოკის სიმაღლეზე, რომელიც ნოდის პროგრამაშია ჩაწერილი. ამ ფორკისთვის მთავარ ქსელზე სიმაღლე არ არსებობს.
განხილვის პროცესში მყოფ კოდში ფორკის სიმაღლე მხოლოდ იმ ლოკალური სატესტო ქსელებისთვისაა დადგენილი, რომლებსაც დეველოპერები იყენებენ. Pearl-ის უახლესი რელიზი, v1.5.5, 2026 წლის 28 ოქტომბრისა, FP8-ის კოდს საერთოდ არ შეიცავს. როცა რელიზი სიმაღლეს დაადგენს, სწორედ ეს რიცხვი უნდა ჩაიწეროთ.
Pearl-ს კონსენსუსი ადრეც რამდენჯერმე შეუცვლია. ყოველი ეს ცვლილება ფიქსირებულ ბლოკზე გააქტიურდა, რომელიც რელიზში იყო დასახელებული. მაინერი, რომელმაც ბლოკის ნომერი იცის და მანამდე განახლდება, არაფერს კარგავს.
რა გავაკეთოთ ახლა
- გააგრძელეთ მაინინგი. თქვენი მაინერი, პარამეტრები და გადახდები ფორკის ბლოკამდე ზუსტად ისე მუშაობს, როგორც ადრე. მონახაზის გამო არაფერი შეცვალოთ.
- იპოვეთ თქვენი ბარათის ოჯახი ზემოთ მოცემულ ცხრილში, ან NVIDIA-ს სიაში მისი გამოთვლითი შესაძლებლობით.
- Hopper ან Blackwell ბარათზე დაგეგმეთ, რომ ფორკის ბლოკამდე დააყენოთ FP8 სქემის მხარდამჭერი მაინერი, როცა ასეთი გამოჩნდება.
- ნებისმიერ სხვა ბარათზე Pearl-ის მაინინგი ფორკის ბლოკამდე გააგრძელეთ. ახლავე აირჩიეთ, რომელ მონეტას მოიპოვებს ბარათი ამის შემდეგ. საუკეთესო მაინინგ GPU-ების სია და მაინინგის კალკულატორი აჩვენებს, რამდენს გამოიმუშავებს თქვენი ბარათი სხვა მონეტებზე.
- ფორკის სიმაღლისთვის თვალი ადევნეთ Pearl-ის რელიზების გვერდს და Pearl-ის წინადადებების რეპოზიტორიას.
- ფორკის დღეს მაინერი პულზე მიღებული შეარებით შეაფასეთ და არა იმ ჰეშრეიტით, რომელსაც ის აჩვენებს. მოძველებულ მაინერს შეუძლია ჯანსაღი ჰეშრეიტი აჩვენოს, მაშინ როცა მისი არცერთი სამუშაო არ ითვლება.
ფიქრობთ Pearl-ისთვის აპარატურის ყიდვაზე? იყიდეთ იმისთვის, რასაც ქსელი დღეს იღებს და რასაც საბოლოო ვერსია მიიღებს. ნუ იყიდით მონახაზისთვის, რომელიც შეიძლება ჯერ კიდევ შეიცვალოს.
ხშირად დასმული კითხვები
გააგრძელებს თუ არა RTX 4090 Pearl-ის მაინინგს FP8 ფორკის შემდეგ?
PIP-3-ის დღევანდელი ტექსტით არა. RTX 4090 Ada ბარათია, Ada კი მონახაზის ჩიპების ოჯახების სიაში არ არის. ეს ასეა, თუმცა მას FP8 მათემატიკა აპარატურულად შეუძლია. ფორკის ბლოკამდე ის Pearl-ს ჩვეულებრივად მოიპოვებს.
გააგრძელებს თუ არა RTX 5090 Pearl-ის მაინინგს?
მონახაზით, დიახ. GeForce RTX 50 სერია Blackwell-ია და განვითარების ტოტის საცნობარო მაინერი მასზე იტვირთება. ჯერ არცერთი გამოქვეყნებული ტესტი არ აჩვენებს FP8 მაინინგს GeForce RTX 50 ბარათზე.
შეძლებენ თუ არა AMD-ისა და Intel-ის GPU-ები Pearl-ის მაინინგს ფორკის შემდეგ?
მონახაზით არა. მონახაზი მხოლოდ NVIDIA Hopper-სა და Blackwell-ს იღებს. AMD-ისა და Intel-ის ბარათებს დღეს Pearl-ის მაინინგი შეუძლიათ, მაინინგის პროგრამის მიხედვით. ამას ისინი ფორკის ბლოკამდე გააგრძელებენ.
რატომ ვერ მოიპოვებს სწრაფი RTX 4090 FP8 Pearl-ს?
პრობლემა სიჩქარე არ არის. ჩიპების ყოველი ოჯახი მცურავი მძიმის მათემატიკას ოდნავ განსხვავებულად ამრგვალებს. ქსელმა მაინერის შედეგი ბიტ-ბიტ უნდა გაიმეოროს. ამისთვის საჭიროა ერთი ფიქსირებული, შეთანხმებული გამოთვლა ყოველი ოჯახისთვის, მონახაზი კი ასეთს მხოლოდ Hopper-სა და Blackwell-ისთვის განსაზღვრავს.
როდის არის Pearl-ის FP8 ფორკი?
თარიღი ან ბლოკის სიმაღლე დადგენილი არ არის. უახლესი რელიზი, 2026 წლის 28 ოქტომბრის v1.5.5, FP8-ის კოდს არ შეიცავს. სიმაღლე რელიზში დასახელდება, როცა მას აირჩევენ.
უნდა გავაკეთო რამე დღეს?
არა. გააგრძელეთ მაინინგი ისე, როგორც ახლა. იმოქმედეთ, როცა რელიზი ფორკის ბლოკს დაასახელებს. განაახლეთ მაინერი, თუ ბარათი Hopper ან Blackwell არის, ან გადაიტანეთ ბარათი სხვა მონეტაზე, თუ არ არის.
საიდან მოდის ეს ფაქტები
აქ ყოველი მტკიცება შემოწმებადია. სქემა, მისი მოტივაცია, აპარატურის თეთრი სია და ღია საკითხები PIP-3-ის ტექსტიდან მოდის. ის Pearl-ის გუნდის საჯარო წინადადებების რეპოზიტორიაშია.
GPU-ების მხარდაჭერა მოდის Pearl-ის რეპოზიტორიის FP8 განვითარების ტოტზე არსებული საცნობარო მაინერიდან. ეს მაინერი თავად ასახელებს ჩიპებს, რომლებზეც იტვირთება.
აქტივაციის სტატუსი იმავე კოდის ქსელის პარამეტრებიდან მოდის. იქ FP8 ფორკის სიმაღლე მხოლოდ სატესტო ქსელებისთვისაა დადგენილი. ის ასევე უახლესი რელიზიდან მოდის.
სადაც წყაროები არაფერს ამბობს, მაგალითად მეხსიერების მოთხოვნებზე ან სხვა მაინერების მხარდაჭერაზე, ეს სტატია ამას პირდაპირ ამბობს. ის არ ვარაუდობს.