






Fork FP8 Pearl diterangkan: GPU mana yang terus melombong
Pearl (PRL) sedang bersedia untuk perubahan terbesarnya sejak dilancarkan. Satu cadangan bernama PIP-3 memindahkan perlombongan Pearl daripada pengiraan integer kepada FP8. FP8 ialah format titik terapung 8-bit yang digunakan oleh model AI moden.
Perubahan ini ialah hard fork, jadi setiap nod perlu dinaik taraf. Seperti yang ditulis hari ini, ia juga memendekkan senarai kad grafik yang boleh melombong.
Artikel ini menerangkan apa yang berubah dan mengapa senarai perkakasan menjadi lebih sempit. Ia menunjukkan kad mana yang terjejas dan apa yang perlu dilakukan selagi belum ada tarikh fork.
Versi ringkas
- Perlombongan Pearl beralih daripada pengiraan integer (INT7) kepada titik terapung 8-bit (FP8), iaitu format nombor yang digunakan oleh model AI.
- Mengikut draf, selepas fork hanya GPU NVIDIA Hopper dan Blackwell boleh melombong. Kad GeForce RTX 40, RTX 30 dan RTX 20 tidak boleh, begitu juga mana-mana GPU AMD atau Intel.
- Tiada blok fork ditetapkan. Keluaran Pearl terkini, v1.5.5 dari 28 Oktober 2026, tidak mengandungi kod FP8.
- Sehingga sesuatu keluaran menamakan blok fork, tiada apa-apa yang berubah. Teruskan melombong seperti hari ini.
Apa yang dikira oleh pelombong Pearl hari ini
Pearl menggunakan Proof of Useful Work (PoUW). Daripada membuat hash nombor rawak, pelombong melakukan kerja yang berguna di luar rantaian. Di sini kerja itu ialah pendaraban matriks, iaitu langkah yang paling banyak menggunakan masa latihan dan inferens AI.
Hingar rawak ditambah pada matriks supaya hasilnya tidak dapat diteka. Hasil darab itu dipotong menjadi blok kecil yang dipanggil jubin. Setiap jubin menjadi nombor yang berfungsi seperti tiket loteri.
Tiket di bawah sasaran kolam dikira sebagai share. Tiket di bawah sasaran rangkaian yang jauh lebih sukar ialah blok. Bukti zero knowledge, iaitu bukti ringkas bahawa pengiraan itu betul, membolehkan setiap nod menyemak kerja itu dengan murah.
Hari ini nilai matriks ialah integer 8-bit dengan satu bit ruang lebihan. Spesifikasi memanggilnya INT7. Hasil darabnya dijumlahkan menjadi integer 32-bit (INT32).
Pengiraan integer memberikan jawapan yang sama pada setiap cip. Itu salah satu sebab Pearl boleh dilombong hari ini pada kad NVIDIA RTX siri 20 dan lebih baharu. Bergantung pada perisian perlombongan, ia juga berjalan pada GPU AMD dan Intel.
Apa yang diubah oleh PIP-3
PIP-3 bertajuk FP PoUW Certificates. Pasukan Pearl menerbitkannya pada 30 Julai 2026 dengan status Draft. Ia menggantikan skim integer dengan skim titik terapung.
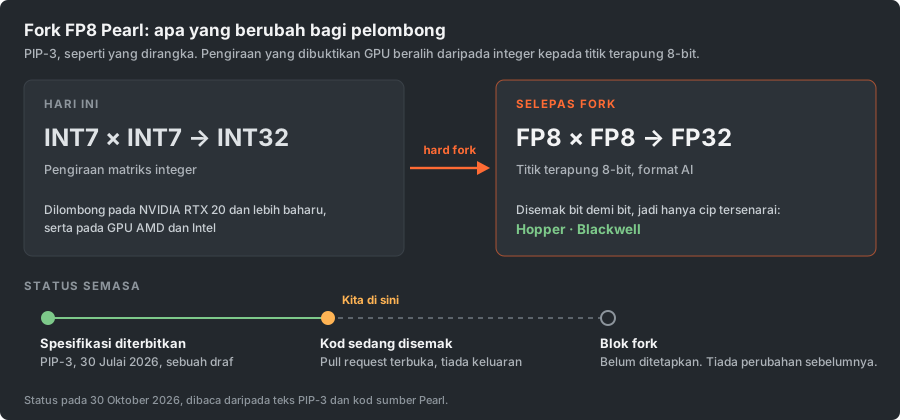
FP8 ialah nombor yang muat dalam 8 bit. Tidak seperti integer, ia juga boleh menyimpan pecahan. PIP-3 menggunakan susun atur E4M3: satu bit tanda, empat bit eksponen dan tiga bit mantisa.
Bit eksponen menentukan saiz nombor, dan bit mantisa menentukan ketepatannya. Nilai E4M3 terbesar ialah 448. Hasil darab dijumlahkan dalam titik terapung 32-bit (FP32).
Setiap baris matriks juga mendapat faktor skalanya sendiri. Itu memastikan nombornya kekal dalam julat FP8 yang kecil.
| Apa yang berubah | Hari ini | Selepas fork FP8, mengikut draf |
|---|---|---|
| Format nombor | INT7, integer 8-bit | FP8, susun atur E4M3 |
| Hasil darab dijumlahkan dalam | INT32, integer 32-bit | FP32, titik terapung 32-bit |
| Jawapan sama pada setiap cip | Ya | Tidak, hanya dalam satu keluarga cip |
| GPU yang boleh melombong | NVIDIA RTX 20 dan lebih baharu; AMD dan Intel, bergantung pada perisian perlombongan | Hanya NVIDIA Hopper dan Blackwell |
Cadangan itu memberikan kebergunaan sebagai sebabnya. Hampir semua model AI bersifat titik terapung. Inferens sebenar sudah pun mendarab dalam FP8 dan menyimpan hasilnya dalam FP32.
Bukti yang dibina pada langkah yang sama boleh berjalan bersama kerja model sebenar. Cadangan itu memanggilnya dua untuk satu yang hampir sempurna.
Perisian perlombongan rujukan pada cabang pembangunan menunjukkan idea ini secara praktikal. Ia ialah pemalam untuk pelayan model vLLM, dan ia melombong semasa GPU melayan model AI.
Cadangan itu terbuka tentang kosnya. Hasil titik terapung tidak sama bit demi bit dengan jawapan ideal, jadi outputnya sedikit hilang ketepatan. Pasukan itu melaporkan tiada perubahan ketepatan yang ketara pada model yang diujinya.
Hasil titik terapung juga berbeza antara keluarga cip. Itu membawa kepada bahagian yang paling penting bagi pelombong.
Mengapa senarai GPU menjadi lebih pendek
Dua keluarga GPU boleh mendarab matriks FP8 yang sama dan masih berbeza pada bit terakhir. Setiap keluarga menjumlahkan dan membundarkan nombor dengan caranya sendiri.
Bagi Pearl, itu masalah sebenar, kerana rangkaian tidak boleh menerima hasil yang sekadar hampir. Cadangan itu menerangkan sebabnya. Sebarang toleransi dalam semakan akan membolehkan pelombong mengubah sedikit output dan mengumpul tiket loteri tambahan tanpa kerja tambahan.
Jadi semakan itu mesti mengulangi pengiraan pelombong dengan tepat.
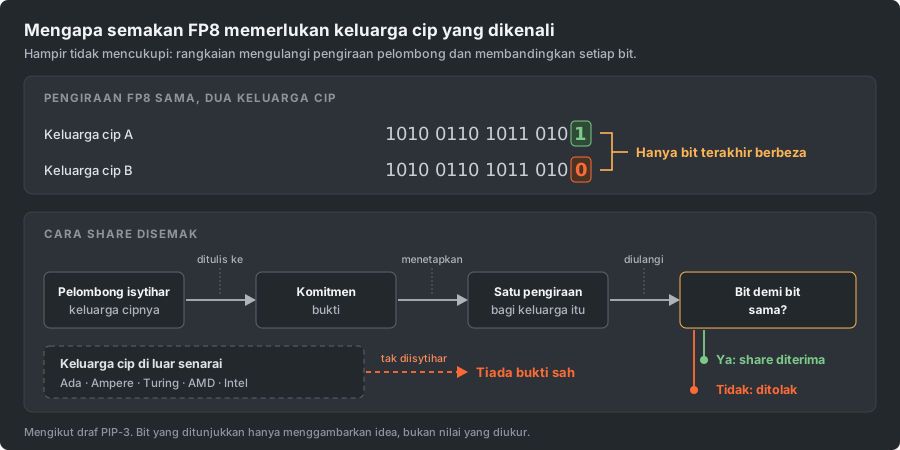
Untuk membolehkannya, pelombong mengisytiharkan keluarga cipnya terlebih dahulu. Keluarga itu ditulis ke dalam komitmen yang menjadi asas setiap bukti. Pelombong dan pengesah kemudian mengikut satu pengiraan tetap bagi keluarga itu.
Hanya keluarga dalam senarai putih boleh diisytiharkan, dan PIP-3 menyenaraikan dua: Hopper dan Blackwell. Kad daripada keluarga lain tiada cara yang sah untuk membuktikan kerjanya. Itu tetap berlaku walau sepantas mana pun kad itu dalam FP8.
GPU mana yang terus melombong, dan mana yang tidak
Perisian perlombongan rujukan pada cabang pembangunan boleh dimuatkan pada cip di bawah. Ia enggan dimuatkan pada cip lain.
Tidak pasti keluarga mana kad anda? Senarai GPU CUDA NVIDIA memberikan compute capability setiap kad. 9.0 ialah Hopper, 10.0 dan ke atas ialah Blackwell, dan 8.9 ialah Ada.
| Keluarga GPU | Contoh kad | Selepas fork, mengikut draf |
|---|---|---|
| Hopper | H100, H200 | Terus melombong |
| Blackwell | B200, RTX PRO 6000, GeForce RTX siri 50 | Terus melombong |
| Ada | Siri GeForce RTX 40, L40S | Berhenti pada blok fork |
| Ampere | Siri GeForce RTX 30, A100 | Berhenti pada blok fork |
| Turing | Siri GeForce RTX 20 | Berhenti pada blok fork |
| AMD dan Intel | Setiap model | Berhenti pada blok fork |
Satu peringatan untuk pemilik GeForce RTX 50. Nota perisian perlombongan rujukan itu sendiri menyatakan bahawa ujiannya dijalankan pada B200.
Nota yang sama menyatakan bahawa satu bentuk jubin belum ada kernel pada kad RTX 50. Jadi lapisan yang hanya boleh dilombong oleh bentuk itu ditinggalkan. Setakat ini tiada ujian yang diterbitkan menunjukkan perlombongan FP8 pada kad GeForce RTX 50.
Ada isu berasingan dengan perisian perlombongan rasmi hari ini pada cabang utama. Ia dibina untuk cip Hopper sahaja. Dua laporan terbuka menunjukkan ia gagal pada kad RTX 50: tiada kernel untuk RTX 50 dan kegagalan GEMM pada RTX 5070.
Dua perkara belum diketahui. Belum ada sesiapa yang menerbitkan berapa banyak memori GPU yang diperlukan oleh skim baharu pada sesuatu kad. Belum ada sesiapa yang boleh memastikan sama ada program perlombongan hari ini akan menyokongnya.
Draf itu mewajibkan setiap pelombong mengikut pengiraan rujukan dengan tepat. Jadi mana-mana program yang mahu melombong selepas fork mesti sepadan dengannya bit demi bit.
Apa yang masih terbuka dalam draf
PIP-3 ialah draf, dan teksnya menyatakan demikian di beberapa tempat. Bahagian-bahagian ini masih ditanda untuk diputuskan sebelum cadangan itu beralih ke status seterusnya:
- Format padat yang boleh digunakan untuk menyimpan matriks sebelum ditukar kepada FP8.
- Semakan statistik yang mesti dilepasi oleh jubin yang menang.
- Vektor ujian dan eksperimen yang diterbitkan.
- Pautan ke perisian perlombongan rujukan.
- Pelan pelaksanaan.
Kod pembangunan juga telah bergerak lebih jauh daripada teks di beberapa tempat. Contohnya, ia sudah mengendalikan lapisan mixture of experts. Itu reka bentuk model AI yang hanya menjalankan sebahagian model bagi setiap input.
Ia juga menomborkan versi sijil dengan cara berbeza. Itu perkara biasa bagi sesuatu draf. Tetapi ia bermakna butirannya masih boleh berubah, termasuk perkakasan mana yang diterima.
Bila ia berlaku
Tiada tarikh. Fork Pearl diaktifkan pada ketinggian blok yang ditulis dalam perisian nod. Tiada ketinggian mainnet untuk fork ini.
Dalam kod yang sedang disemak, ketinggian fork hanya ditetapkan untuk rangkaian ujian tempatan yang digunakan oleh pembangun. Keluaran Pearl terkini, v1.5.5 dari 28 Oktober 2026, langsung tidak mengandungi kod FP8. Apabila sesuatu keluaran menetapkan ketinggian, nombor itulah yang perlu dicatat.
Pearl telah menukar konsensus beberapa kali sebelum ini. Setiap perubahan itu diaktifkan pada blok tetap yang dinamakan dalam sesuatu keluaran. Pelombong yang tahu nombor blok itu dan mengemas kini sebelumnya tidak kehilangan apa-apa.
Apa yang perlu dilakukan sekarang
- Teruskan melombong. Perisian perlombongan, tetapan dan bayaran anda berfungsi sama seperti sebelum ini sehingga blok fork. Jangan ubah apa-apa kerana sebuah draf.
- Cari keluarga kad anda dalam jadual di atas, atau melalui compute capability kad itu dalam senarai NVIDIA.
- Pada kad Hopper atau Blackwell, rancang untuk memasang perisian perlombongan yang menyokong skim FP8 sebelum blok fork, apabila perisian sedemikian wujud.
- Pada kad lain, teruskan melombong Pearl sehingga blok fork. Pilih sekarang syiling mana yang akan dilombong oleh kad itu selepas itu. Senarai GPU perlombongan terbaik dan kalkulator perlombongan menunjukkan pendapatan kad anda pada syiling lain.
- Pantau halaman keluaran Pearl dan repositori cadangan Pearl untuk ketinggian fork.
- Pada hari fork, nilailah perisian perlombongan anda berdasarkan share diterima di kolam, bukan hashrate yang dipaparkannya. Perisian perlombongan yang lapuk boleh melaporkan hashrate yang sihat sedangkan tiada satu pun kerjanya dikira.
Bercadang membeli perkakasan untuk Pearl? Belilah untuk apa yang diterima oleh rangkaian hari ini dan apa yang diterima oleh versi akhir. Jangan beli untuk draf yang masih boleh berubah.
Soalan lazim
Adakah RTX 4090 masih boleh melombong Pearl selepas fork FP8?
Tidak, mengikut PIP-3 seperti yang ditulis hari ini. RTX 4090 ialah kad Ada, dan Ada tiada dalam senarai keluarga cip draf itu. Itu tetap benar walaupun ia boleh melakukan pengiraan FP8 dalam perkakasan. Ia terus melombong Pearl seperti biasa sehingga blok fork.
Adakah RTX 5090 terus melombong Pearl?
Mengikut draf, ya. GeForce RTX siri 50 ialah Blackwell, dan perisian perlombongan rujukan pada cabang pembangunan boleh dimuatkan padanya. Belum ada ujian yang diterbitkan menunjukkan perlombongan FP8 pada kad GeForce RTX 50.
Bolehkah GPU AMD atau Intel melombong Pearl selepas fork?
Tidak, mengikut draf. Draf hanya menerima NVIDIA Hopper dan Blackwell. Kad AMD dan Intel boleh melombong Pearl hari ini, bergantung pada perisian perlombongan. Ia terus berbuat demikian sehingga blok fork.
Mengapa RTX 4090 yang pantas tidak boleh melombong Pearl FP8?
Kelajuan bukan masalahnya. Setiap keluarga cip membundarkan pengiraan titik terapung dengan sedikit berbeza. Rangkaian mesti mengulangi hasil pelombong bit demi bit. Itu memerlukan satu pengiraan tetap yang dipersetujui bagi setiap keluarga, dan draf hanya mentakrifkannya untuk Hopper dan Blackwell.
Bilakah fork FP8 Pearl?
Tiada tarikh atau ketinggian blok ditetapkan. Keluaran terkini, v1.5.5 dari 28 Oktober 2026, tidak mengandungi kod FP8. Ketinggian akan dinamakan dalam sesuatu keluaran setelah ia dipilih.
Adakah saya perlu melakukan apa-apa hari ini?
Tidak. Teruskan melombong seperti sekarang. Bertindak apabila sesuatu keluaran menamakan blok fork. Kemas kini perisian perlombongan anda jika kad anda Hopper atau Blackwell, atau pindahkan kad ke syiling lain jika bukan.
Dari mana fakta ini datang
Setiap kenyataan di sini boleh disemak. Skim itu, motivasinya, senarai putih perkakasan dan perkara yang masih terbuka datang daripada teks PIP-3. Ia terletak dalam repositori cadangan awam pasukan Pearl.
Sokongan GPU datang daripada perisian perlombongan rujukan pada cabang pembangunan FP8 dalam repositori Pearl. Perisian itu menyatakan cip yang boleh memuatkannya.
Status pengaktifan datang daripada parameter rangkaian dalam kod yang sama. Di situ, ketinggian fork FP8 hanya ditetapkan untuk rangkaian ujian. Ia juga datang daripada keluaran terkini.
Apabila sumber tidak menyatakan apa-apa, seperti keperluan memori atau sokongan dalam perisian perlombongan lain, artikel ini berkata begitu. Ia tidak meneka.