






Pearl FP8 fork'u: hangi GPU'lar kazmaya devam ediyor
Pearl (PRL), çıkışından bu yana en büyük değişikliğine hazırlanıyor. PIP-3 adlı bir öneri, Pearl madenciliğini tam sayı matematiğinden FP8'e taşıyor. FP8, modern yapay zeka modellerinin çalıştığı 8 bitlik kayan nokta biçimidir.
Değişiklik bir hard fork, yani her node'un yükseltilmesi gerekiyor. Bugün yazıldığı haliyle, kazabilen ekran kartlarının listesini de kısaltıyor.
Bu yazı neyin değiştiğini ve donanım listesinin neden daraldığını açıklıyor. Hangi kartların etkilendiğini ve henüz bir fork tarihi yokken ne yapmanız gerektiğini gösteriyor.
Kısaca
- Pearl madenciliği tam sayı matematiğinden (INT7), yapay zeka modellerinin çalıştığı sayı biçimi olan 8 bitlik kayan noktaya (FP8) geçiyor.
- Taslağa göre fork'tan sonra yalnızca NVIDIA Hopper ve Blackwell GPU'lar kazabiliyor. GeForce RTX 40, RTX 30 ve RTX 20 kartlar kazamıyor; hiçbir AMD ya da Intel GPU da kazamıyor.
- Bir fork bloğu belirlenmedi. En son Pearl sürümü, 28 Ekim 2026 tarihli v1.5.5, hiç FP8 kodu içermiyor.
- Bir sürüm fork bloğunu belirleyene kadar hiçbir şey değişmiyor. Bugün nasıl kazıyorsanız öyle kazmaya devam edin.
Pearl madencileri bugün ne hesaplıyor
Pearl, Faydalı İş İspatı (Proof of Useful Work, PoUW) kullanır. Madenci rastgele sayıların hash'ini almak yerine zincirin dışında da işe yarayan bir iş yapar. Burada bu iş matris çarpımıdır. Yapay zeka eğitimi ve çıkarımı zamanının çoğunu bu adımda harcar.
Sonucun tahmin edilememesi için matrislere rastgele gürültü eklenir. Çarpım, tile denen küçük bloklara bölünür. Her tile, piyango bileti gibi işleyen bir sayıya dönüşür.
Havuzun hedefinin altındaki bir bilet share sayılır. Çok daha zor olan ağ hedefinin altındaki bir bilet ise bloktur. Bir sıfır bilgi ispatı, yani hesabın doğru yapıldığını gösteren kısa bir ispat, her node'un bu işi ucuza kontrol etmesini sağlar.
Bugün matris değerleri, bir bitlik pay bırakılmış 8 bitlik tam sayılardır. Şartname bunlara INT7 diyor. Çarpımlar 32 bitlik tam sayılarda (INT32) toplanır.
Tam sayı matematiği her çipte aynı cevabı verir. Pearl'ün bugün NVIDIA RTX 20 serisi ve daha yeni kartlarda kazılabilmesinin bir nedeni budur. Madencilik yazılımına bağlı olarak AMD ve Intel GPU'larda da çalışır.
PIP-3 neyi değiştiriyor
PIP-3, FP PoUW Certificates başlığını taşıyor. Pearl ekibi onu 30 Temmuz 2026'da Taslak (Draft) durumuyla yayımladı. Tam sayı şemasının yerine kayan noktalı bir şema koyuyor.
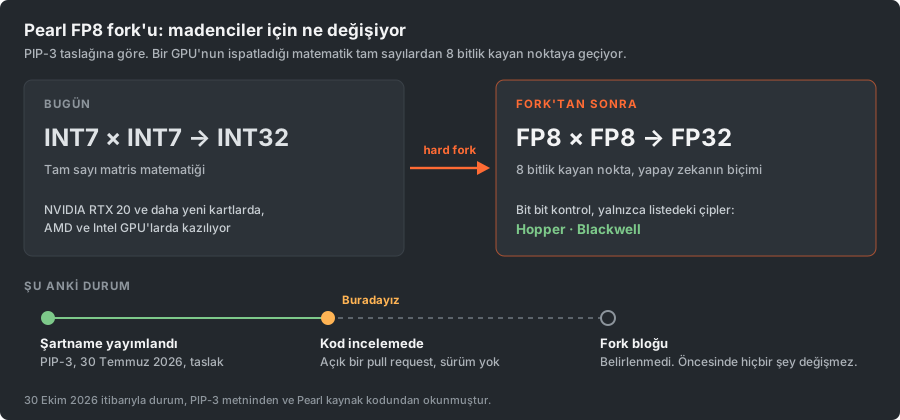
FP8, 8 bite sığan bir sayıdır. Tam sayıdan farklı olarak kesirli değerleri de tutabilir. PIP-3 E4M3 düzenini kullanıyor: bir işaret biti, dört üs biti ve üç mantis biti.
Üs bitleri sayının büyüklüğünü, mantis bitleri ise hassasiyetini belirler. En büyük E4M3 değeri 448'dir. Çarpımlar 32 bitlik kayan noktada (FP32) toplanır.
Bir matrisin her satırı ayrıca kendi ölçek çarpanını alır. Böylece sayıları FP8'in dar aralığında kalır.
| Ne değişir | Bugün | FP8 fork'undan sonra, taslağa göre |
|---|---|---|
| Sayı biçimi | INT7, 8 bitlik bir tam sayı | FP8, E4M3 düzeni |
| Çarpımların toplandığı yer | INT32, 32 bitlik bir tam sayı | FP32, 32 bitlik kayan nokta |
| Her çipte aynı cevap | Evet | Hayır, yalnızca tek bir çip ailesi içinde |
| Kazabilen GPU'lar | NVIDIA RTX 20 ve daha yenileri; madencilik yazılımına bağlı olarak AMD ve Intel | Yalnızca NVIDIA Hopper ve Blackwell |
Öneri gerekçe olarak faydayı gösteriyor. Yapay zeka modellerinin neredeyse hepsi doğası gereği kayan noktalıdır. Gerçek çıkarım zaten FP8'de çarpar ve sonuçları FP32'de tutar.
Aynı adım üzerine kurulan bir ispat, gerçek model işinin yanında birlikte yürüyebilir. Öneri buna neredeyse kusursuz bir ikisi bir arada diyor.
Geliştirme dalındaki referans madencilik yazılımı fikri pratikte gösteriyor. vLLM model sunucusu için bir eklenti olarak çalışıyor ve GPU bir yapay zeka modeline hizmet verirken kazıyor.
Öneri bedeli konusunda açık. Kayan noktalı sonuçlar ideal cevapla bit bit aynı değildir, bu yüzden çıktı biraz kayıplıdır. Ekip, test ettiği modellerde doğrulukta fark edilir bir değişiklik görmediğini bildiriyor.
Kayan noktalı sonuçlar çip aileleri arasında da farklılık gösterir. Bu da madenciler için en önemli kısma götürüyor.
GPU listesi neden kısalıyor
İki GPU ailesi aynı FP8 matrislerini çarpıp yine de son bitte farklı sonuç alabilir. Her aile sayıları kendi yöntemiyle toplar ve yuvarlar.
Pearl için bu gerçek bir sorun, çünkü ağ yalnızca yakın olan bir sonucu kabul edemez. Öneri nedenini açıklıyor. Kontroldeki herhangi bir tolerans, bir madencinin çıktıyı biraz oynatıp fazladan iş yapmadan fazladan piyango bileti toplamasına izin verirdi.
Bu yüzden kontrolün madencinin hesabını tam olarak tekrarlaması gerekiyor.
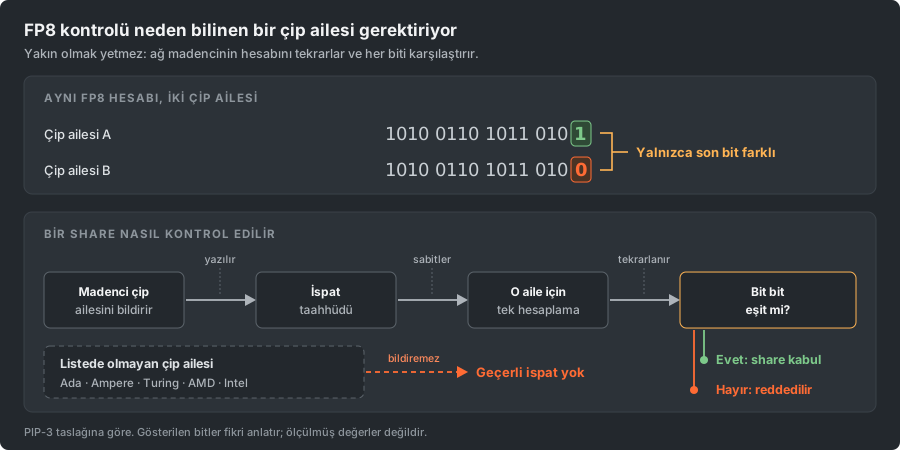
Bunu mümkün kılmak için madenci çip ailesini baştan bildirir. Aile, her ispatın üzerine kurulduğu taahhüde yazılır. Madenci ve doğrulayıcı sonra o aile için tek bir sabit hesaplamayı izler.
Yalnızca beyaz listedeki aileler bildirilebilir ve PIP-3 iki aileyi listeliyor: Hopper ve Blackwell. Başka bir aileden bir kartın işini ispatlamanın geçerli bir yolu yok. Kart FP8'de ne kadar hızlı olursa olsun bu değişmez.
Hangi GPU'lar kazmaya devam ediyor, hangileri etmiyor
Geliştirme dalındaki referans madencilik yazılımı aşağıdaki çiplerde yükleniyor. Başka hiçbir şeyde yüklenmeyi reddediyor.
Kartınızın hangi aileye ait olduğundan emin değil misiniz? NVIDIA'nın CUDA GPU listesi her kartın compute capability değerini veriyor. 9.0 Hopper, 10.0 ve üstü Blackwell, 8.9 ise Ada demek.
| GPU ailesi | Örnek kartlar | Fork'tan sonra, taslağa göre |
|---|---|---|
| Hopper | H100, H200 | Kazmaya devam eder |
| Blackwell | B200, RTX PRO 6000, GeForce RTX 50 serisi | Kazmaya devam eder |
| Ada | GeForce RTX 40 serisi, L40S | Fork bloğunda duruyor |
| Ampere | GeForce RTX 30 serisi, A100 | Fork bloğunda duruyor |
| Turing | GeForce RTX 20 serisi | Fork bloğunda duruyor |
| AMD ve Intel | Tüm modeller | Fork bloğunda duruyor |
GeForce RTX 50 sahipleri için bir uyarı. Referans madencilik yazılımının kendi notları, testlerinin bir B200 üzerinde çalıştığını söylüyor.
Aynı notlara göre RTX 50 kartlarda tile şekillerinden biri için henüz kernel yok. Bu yüzden yalnızca o şekille kazılabilen katmanlar dışarıda kalıyor. Şimdiye kadar yayımlanmış hiçbir test, bir GeForce RTX 50 kartında FP8 madenciliği göstermiyor.
Bugün ana daldaki resmi madencilik yazılımında ayrı bir sorun var. Yalnızca Hopper çipleri için derleniyor. Açık iki rapor, RTX 50 kartlarda hata verdiğini gösteriyor: RTX 50 için kernel yok ve RTX 5070'te bir GEMM hatası.
İki şey henüz bilinmiyor. Yeni şemanın belirli bir kartta ne kadar GPU belleği gerektirdiğini kimse yayımlamadı. Bugünkü madencilik yazılımlarının onu destekleyip desteklemeyeceğini de henüz kimse söyleyemiyor.
Taslak, her madencilik yazılımının referans hesaplamayı tam olarak izlemesini şart koşuyor. Bu yüzden fork'tan sonra kazmak isteyen her yazılımın ona bit bit uyması gerekiyor.
Taslakta hâlâ açık olanlar
PIP-3 bir taslak ve metin bunu birkaç yerde söylüyor. Şu kısımlar, öneri bir sonraki duruma geçmeden önce karara bağlanacak olarak hâlâ işaretli:
- Matrislerin FP8'e dönüştürülmeden önce saklanabileceği sıkıştırılmış biçim.
- Kazanan bir tile'ın geçmesi gereken istatistiksel kontroller.
- Test vektörleri ve yayımlanan deneyler.
- Referans madencilik yazılımına bağlantı.
- Dağıtım planı.
Geliştirme kodu da yer yer metnin önüne geçmiş. Örneğin mixture of experts katmanlarını şimdiden işliyor. Bu, her girdi için modelin yalnızca bir kısmının çalıştığı yapay zeka model tasarımıdır.
Sertifika sürümünü de farklı numaralandırıyor. Bir taslak için bu normal. Ama hangi donanımın kabul edildiği de dahil, ayrıntıların hâlâ değişebileceği anlamına geliyor.
Ne zaman gerçekleşecek
Bir tarih yok. Bir Pearl fork'u, node yazılımına yazılan bir blok yüksekliğinde devreye girer. Bu fork için bir mainnet yüksekliği yok.
İncelemedeki kodda fork yüksekliği yalnızca geliştiricilerin kullandığı yerel test ağları için belirlenmiş. 28 Ekim 2026 tarihli en son Pearl sürümü, v1.5.5, hiç FP8 kodu içermiyor. Bir sürüm bir yükseklik belirlediğinde not etmeniz gereken sayı odur.
Pearl konsensüsünü daha önce birkaç kez değiştirdi. Bu değişikliklerin her biri, bir sürümde adı verilen sabit bir blokta devreye girdi. Blok numarasını bilen ve ondan önce güncelleyen bir madenci hiçbir şey kaybetmez.
Şimdi ne yapmalı
- Kazmaya devam edin. Madencilik yazılımınız, ayarlarınız ve ödemeleriniz fork bloğuna kadar tam olarak eskisi gibi çalışıyor. Bir taslak yüzünden hiçbir şeyi değiştirmeyin.
- Kartınızın ailesini yukarıdaki tabloda ya da NVIDIA'nın listesindeki compute capability değerinden bulun.
- Hopper ya da Blackwell bir kartınız varsa, FP8 şemasını destekleyen bir madencilik yazılımı çıktığında onu fork bloğundan önce kurmayı planlayın.
- Başka bir kartınız varsa, fork bloğuna kadar Pearl kazmaya devam edin. Kartın sonrasında hangi coin'i kazacağına şimdiden karar verin. En iyi madencilik GPU'ları listesi ve madencilik hesaplayıcısı kartınızın diğer coin'lerde ne kazandığını gösteriyor.
- Bir fork yüksekliği için Pearl sürümler sayfasını ve Pearl öneri deposunu takip edin.
- Fork günü madencilik yazılımınızı ekrana yazdığı hashrate'e göre değil, havuzdaki kabul edilen share'lerine göre değerlendirin. Eski bir madencilik yazılımı, işinin hiçbiri sayılmazken sağlıklı bir hashrate gösterebilir.
Pearl için donanım almayı mı düşünüyorsunuz? Ağın bugün kabul ettiğine ve son sürümün kabul edeceğine göre alın. Hâlâ değişebilecek bir taslağa göre almayın.
Sıkça sorulan sorular
RTX 4090, FP8 fork'undan sonra Pearl kazmaya devam edecek mi?
PIP-3'ün bugün yazıldığı haliyle hayır. RTX 4090 bir Ada kartı ve Ada, taslaktaki çip aileleri listesinde yok. Kart FP8 matematiğini donanımda yapabilse bile bu böyle. Fork bloğuna kadar Pearl'ü normal şekilde kazmaya devam ediyor.
RTX 5090 Pearl kazmaya devam ediyor mu?
Taslağa göre evet. GeForce RTX 50 serisi Blackwell ve geliştirme dalındaki referans madencilik yazılımı bu kartlarda yükleniyor. Yayımlanmış hiçbir test henüz bir GeForce RTX 50 kartında FP8 madenciliği göstermiyor.
AMD ya da Intel GPU'lar fork'tan sonra Pearl kazabilir mi?
Taslağa göre hayır. Taslak yalnızca NVIDIA Hopper ve Blackwell'i kabul ediyor. AMD ve Intel kartlar bugün, madencilik yazılımına bağlı olarak, Pearl kazabiliyor. Fork bloğuna kadar kazmaya devam ediyorlar.
Hızlı bir RTX 4090 neden FP8 Pearl kazamıyor?
Sorun hız değil. Her çip ailesi kayan nokta matematiğini biraz farklı yuvarlar. Ağın madencinin sonucunu bit bit tekrarlaması gerekir. Bunun için her aileye tek bir sabit, üzerinde anlaşılmış hesaplama gerekiyor ve taslak bunu yalnızca Hopper ve Blackwell için tanımlıyor.
Pearl FP8 fork'u ne zaman?
Bir tarih ya da blok yüksekliği belirlenmedi. En son sürüm, 28 Ekim 2026 tarihli v1.5.5, hiç FP8 kodu içermiyor. Bir yükseklik seçildiğinde bir sürümde adı verilecek.
Bugün bir şey yapmam gerekiyor mu?
Hayır. Şu an nasıl kazıyorsanız öyle devam edin. Bir sürüm fork bloğunu belirlediğinde harekete geçin. Kartınız Hopper ya da Blackwell ise madencilik yazılımınızı güncelleyin, değilse kartı başka bir coin'e taşıyın.
Bu bilgiler nereden geliyor
Buradaki her ifade kontrol edilebilir. Şema, gerekçesi, donanım beyaz listesi ve açık maddeler PIP-3 metninden geliyor. Bu metin, Pearl ekibinin herkese açık öneri deposunda duruyor.
GPU desteği, Pearl deposunun FP8 geliştirme dalındaki referans madencilik yazılımından geliyor. Bu yazılım hangi çiplerde yüklendiğini belirtiyor.
Devreye girme durumu, aynı koddaki ağ parametrelerinden geliyor. Orada FP8 fork yüksekliği yalnızca test ağları için belirlenmiş. Bu durum ayrıca en son sürümden de geliyor.
Kaynakların bir şey söylemediği yerlerde, örneğin bellek ihtiyacı ya da diğer madencilik yazılımlarındaki destek konusunda, bu yazı bunu açıkça söylüyor. Tahmin yürütmüyor.